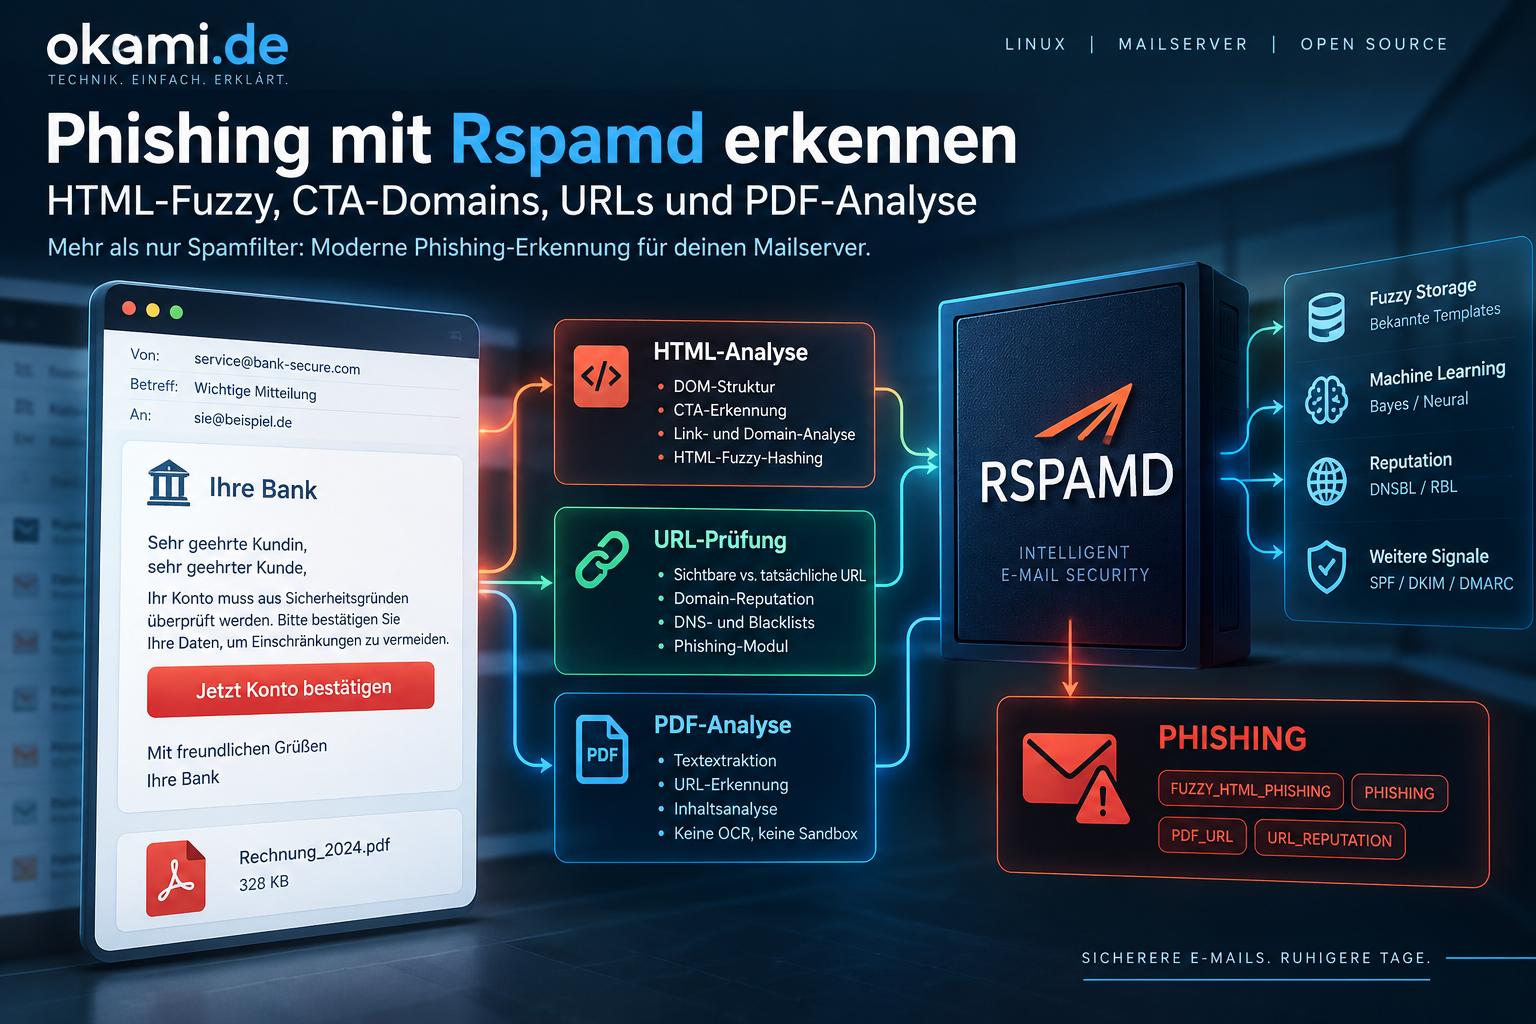
Phishing-Mails sind längst nicht mehr darauf angewiesen, durch offensichtliche Rechtschreibfehler, merkwürdige Absender oder primitive HTML-Links aufzufallen. Gut gemachte Kampagnen übernehmen das Design legitimer Benachrichtigungen nahezu vollständig, tauschen nur die Zieladresse eines Login-Buttons aus oder verlagern einen Teil des Angriffs in einen Anhang. Klassische Prüfungen auf Absenderreputation, SPF, DKIM oder einzelne verdächtige Wörter bleiben wichtig, reichen allein aber nicht mehr aus.
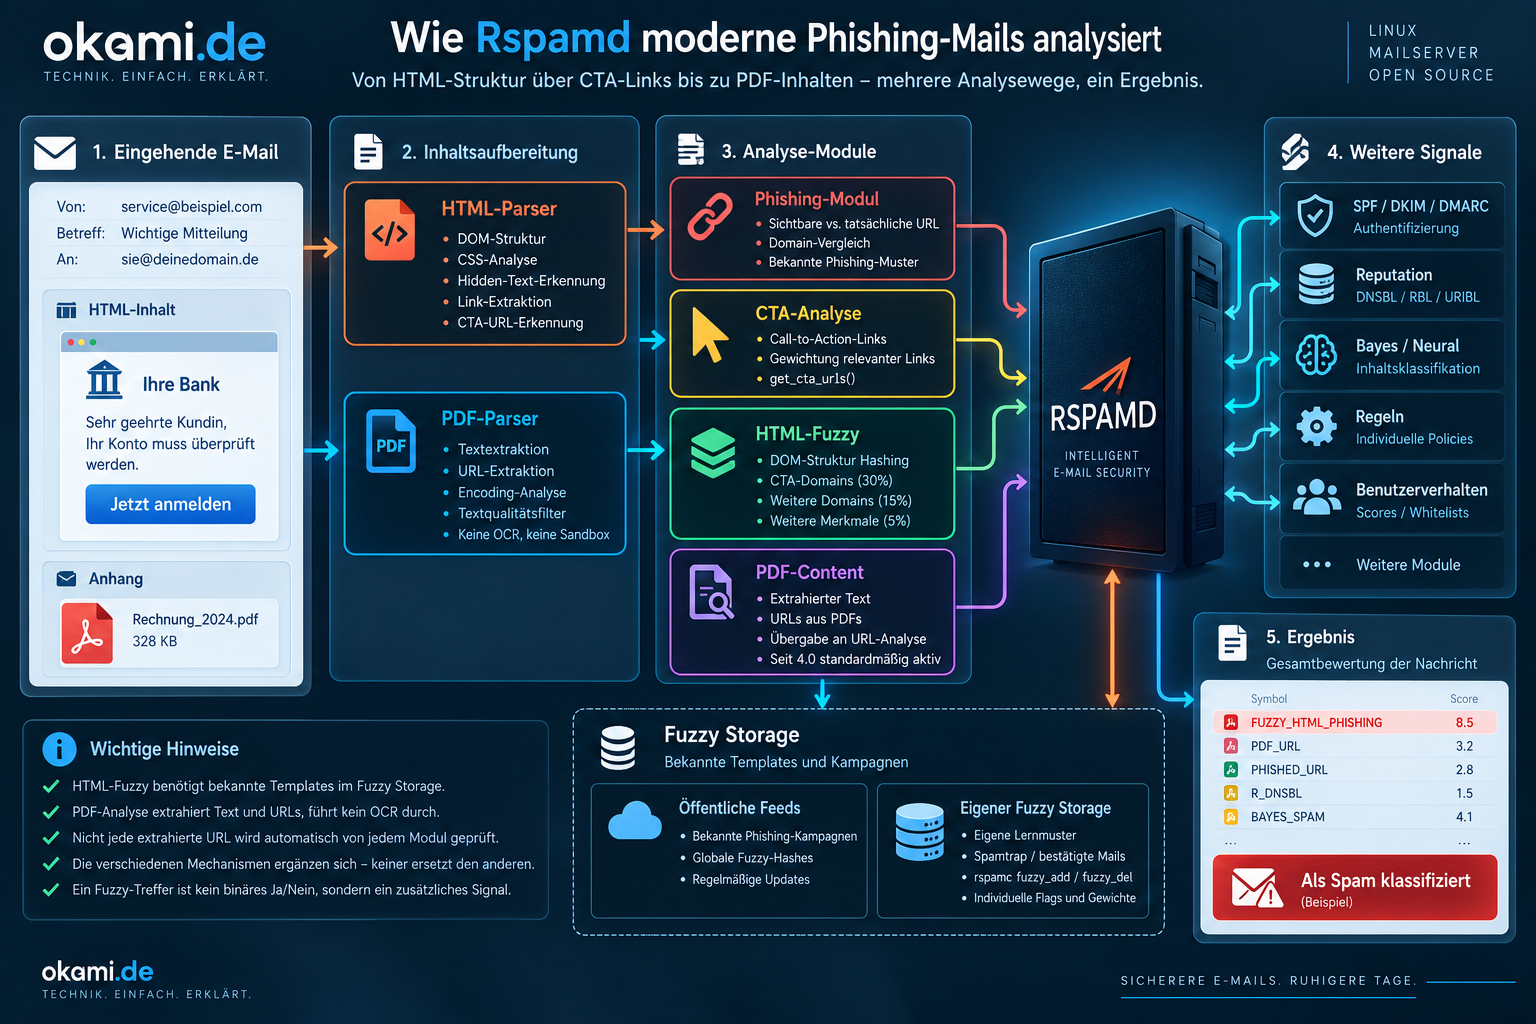
Rspamd begegnet diesem Problem inzwischen auf mehreren Ebenen. Neben der klassischen URL-Prüfung kann der Spamfilter HTML-Strukturen vergleichen, Call-to-Action-Links gesondert betrachten, bekannte Nachrichten über Fuzzy Hashing wiedererkennen und Inhalte aus PDF-Anhängen in die weitere Analyse einbeziehen. Seit Rspamd 3.14 kamen insbesondere HTML-Fuzzy und CTA-Verarbeitung hinzu; Rspamd 4.0 ergänzte unter anderem eine domain-sensitive HTML-Fuzzy-Erkennung sowie die standardmäßige Einbeziehung von Content-URLs. Rspamd 4.1.x hat diese Mechanismen anschließend weiter ausgebaut und insbesondere Fuzzy-Diagnostik sowie PDF-Textextraktion verbessert. Referenzstand dieses Artikels ist Rspamd 4.1.5 vom 14. August 2026.
Warum klassische Phishing-Erkennung nicht ausreicht
Ein klassischer Phishing-Versuch kann relativ einfach aussehen:
<a href="https://evil.example">
    https://bank.example
</a>
Der Benutzer sieht eine vermeintlich legitime Adresse, tatsächlich verweist der Link jedoch auf eine andere Domain. Solche Fälle kann das phishing-Modul von Rspamd erkennen, indem sichtbare und tatsächliche Linkziele miteinander verglichen werden.
Dieses Verfahren deckt aber nur einen Teil moderner Angriffe ab. Ein Angreifer muss dem Empfänger keinen Domainnamen präsentieren. Häufig sieht der Benutzer lediglich einen Button:
Ihr Konto muss überprüft werden.

[ Konto bestätigen ]
Die eigentliche Domain steckt nur im href. Noch schwieriger wird es, wenn komplette HTML-Templates legitimer Nachrichten übernommen werden. Logos, Tabellen, Farben, Abstände und Buttonpositionen bleiben fast unverändert, während lediglich das Ziel hinter dem Button ausgetauscht wird.
Genau hier werden strukturelle Analyse, CTA-Erkennung und Fuzzy Matching interessant.
HTML-Fuzzy vergleicht nicht nur Text
Mit Rspamd 3.14 wurde HTML Structure Fuzzy Hashing eingeführt. Anders als klassisches Text-Fuzzy konzentriert sich dieser Mechanismus auf strukturelle Eigenschaften des HTML-Dokuments. DOM-Struktur, Klassen, Domains und bestimmte Linkeigenschaften können damit in eine Fuzzy-Repräsentation einfließen. Rspamd 4.0 hat dieses Verfahren noch erweitert und unterstützt einen dualen Ansatz aus Template-Matching und domain-sensitiver Phishing-Erkennung.
Eine stark vereinfachte legitime Nachricht könnte beispielsweise so aussehen:
html
 └─ body
    ├─ div.header
    │  └─ img@brand.de
    │
    ├─ div.content
    │  ├─ h1
    │  ├─ p
    │  └─ a.button@brand.de
    │
    └─ div.footer
       └─ a@brand.de
Ein Angreifer kann den Text fast beliebig verändern. Aus „Ihr Konto wurde eingeschränkt“ kann „Aus Sicherheitsgründen ist eine Bestätigung erforderlich“ werden. Die eigentliche HTML-Struktur kann trotzdem weitgehend gleich bleiben.
Der Vorteil liegt darin, dass sich die Erkennung damit nicht ausschließlich auf einzelne Wörter oder einen exakten Body-Hash stützt. Wiederverwendete Kampagnen oder kopierte Templates können auch dann Ähnlichkeiten zeigen, wenn Texte, Empfänger oder einzelne Inhalte verändert wurden.
CTA-Domains: Welcher Link ist wirklich relevant?
Rspamd stellt CTA-URLs über die Lua-API separat zur Verfügung. Das ist wichtig, weil eine normale HTML-Mail sehr viele Links enthalten kann: Logo, Impressum, Datenschutz, Social Media, Abmelde-Link, Tracking-Links und schließlich vielleicht einen zentralen Button wie „Konto bestätigen“.
Nicht alle Links sind für Phishing gleich relevant. Für einen Angriff ist meist entscheidend, wohin der Benutzer durch die zentrale Handlungsaufforderung geführt wird.
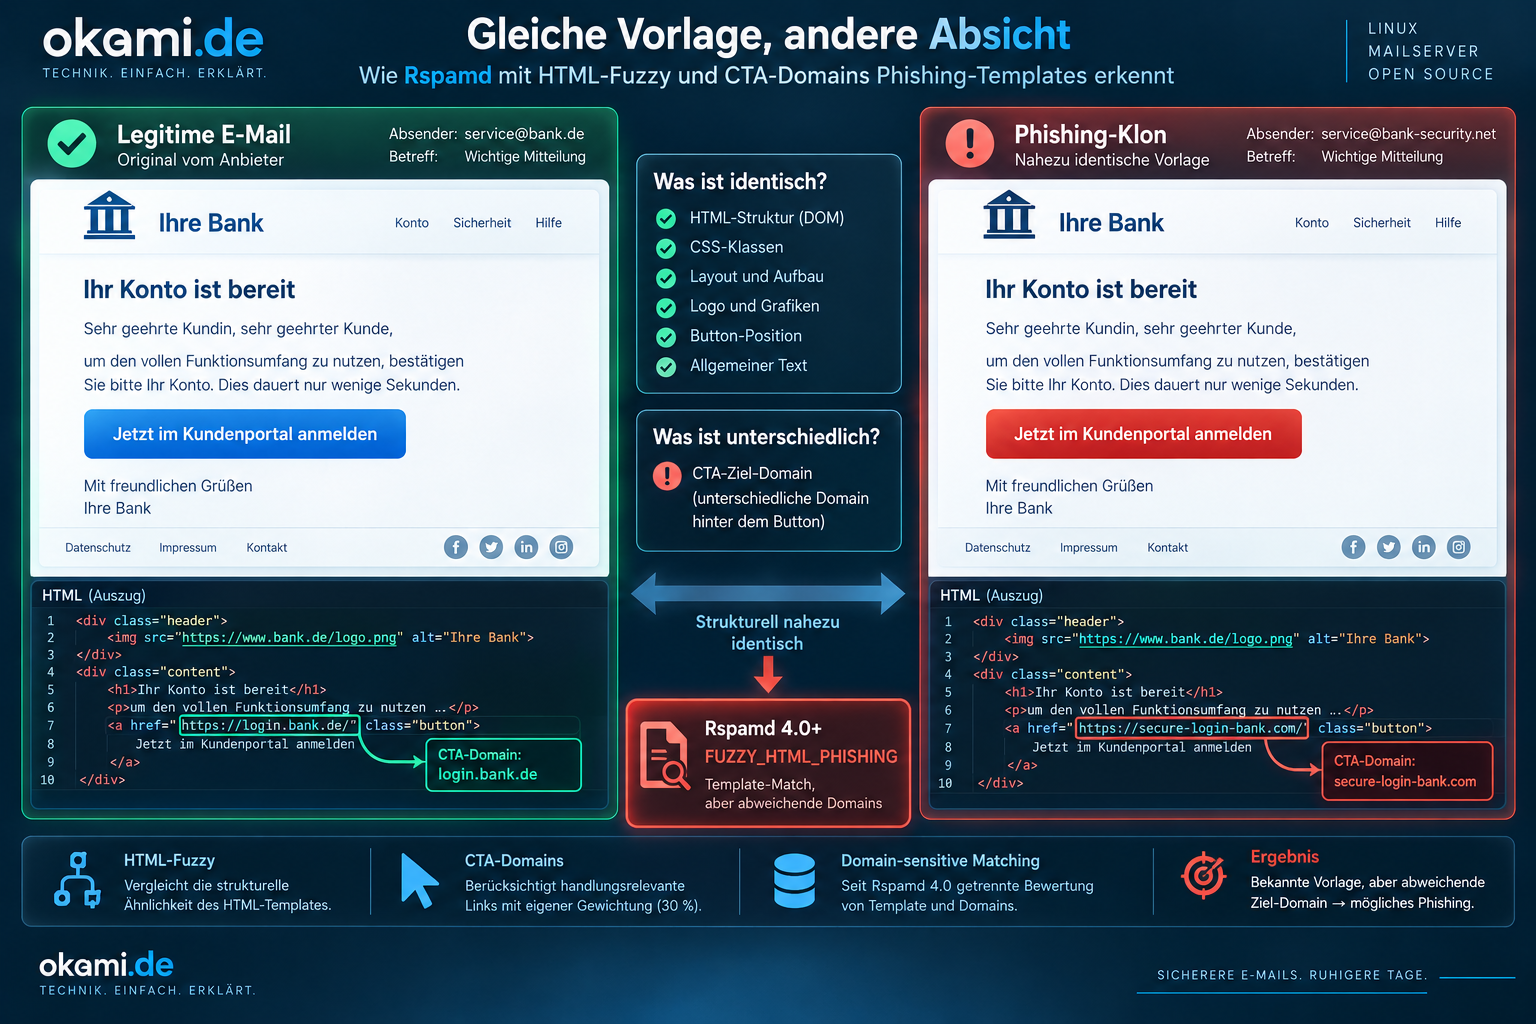
Eine legitime Mail könnte beispielsweise enthalten:
CTA:
https://login.bank.example/
während der Phishing-Klon dieselbe Struktur nutzt, aber auf
https://secure-bank-login.example-attacker.tld/verweist.
Rspamd 4.0 führte mit FUZZY_HTML_PHISHING ausdrücklich eine Erkennung für den Fall ein, dass ein HTML-Template ähnlich ist, die verwendeten Domains aber abweichen. Das ist ein wichtiger Unterschied zur vereinfachten Vorstellung eines einzigen Fuzzy-Wertes.
In der Praxis sollte man sich allerdings nicht ausschließlich auf diesen Mechanismus verlassen. Unser eigener Test mit zwei unterschiedlichen ELSTER-Phishing-Mails zeigte genau diese Grenze: Eine Nachricht wurde in den lokalen HTML-Fuzzy-Storage eingelernt, die zweite ELSTER-Mail war strukturell jedoch nicht ähnlich genug, um denselben HTML-Fuzzy-Treffer auszulösen.
Die Marke war gleich, der Angriffstyp ähnlich, das HTML-Template aber unterschiedlich. Genau deshalb lohnt sich neben Fuzzy eine zweite, regelbasierte CTA-Ebene.
Brand und CTA als zusätzliche Schutzschicht
Auf meinem Mailserver existiert bereits eine Brand-Erkennung, die bekannte Markenbezeichnungen wie ELSTER, PayPal, Klarna, DHL, Amazon, Microsoft oder Apple in verdächtigen Absenderdarstellungen erkennt. Ein realer ELSTER-Phishing-Versuch wurde beispielsweise bereits mit folgendem Symbol erkannt:
BRAND_SPOOF_DISPLAY (6.00)[ELSTER Servicezentrum]Rspamd extrahierte aus derselben Nachricht unter anderem das tatsächliche Ziel:
carve-talon-grain-quiet-488ffd48.s3.sa-east-1.amazonaws.comDie Nachricht behauptete also, von ELSTER zu stammen, führte den Benutzer aber auf einen Amazon-S3-Endpunkt.
Daraus lässt sich eine zusätzliche Erkennungsschicht bauen:
erkannte Marke
      +
tatsächliche CTA-Domain
      +
zulässige Domains dieser Marke
      ↓
Domain passt nicht
      ↓
PHISH_BRAND_CTA
Im realen Test ergab das:
BRAND_SPOOF_DISPLAY (6.00)[ELSTER Servicezentrum]

PHISH_BRAND_CTA (5.00)
[ELSTER:carve-talon-grain-quiet-488ffd48.s3.sa-east-1.amazonaws.com]
Damit lässt sich ein Angriff auch dann erkennen, wenn kein passender HTML-Fuzzy-Hash existiert.
Wichtig ist dabei, keine allgemeine URL-Whitelist zweckzuentfremden. Eine Domain kann für Microsoft legitim sein, aber nicht automatisch für PayPal oder ELSTER. Sinnvoller ist deshalb eine explizite Brand-zu-Domain-Zuordnung:
ELSTER      elster.de
PayPal      paypal.com,paypal.de,paypalobjects.com
Klarna      klarna.com,klarna.de,klarna.se
DHL         dhl.de,dhl.com
Amazon      amazon.de,amazon.com,amazon.co.uk
Microsoft   microsoft.com,microsoftonline.com,office.com
Apple       apple.com
Die CTA-Regel lädt diese Map und prüft anschließend, ob die in der Nachricht gefundenen Ziel-Domains zur erkannten Marke passen. Die Pflege bleibt damit überschaubar und die Logik eindeutig.
Ein eigener Fuzzy-Storage ist kein Automatismus
Der Name „Fuzzy“ kann leicht den Eindruck vermitteln, Rspamd würde selbstständig wissen, welches HTML-Template zu einer Bank, einem Paketdienst oder Microsoft gehört. Das ist nicht der Fall. Fuzzy Matching benötigt bekannte Daten, gegen die neue Nachrichten verglichen werden können.
Rspamd kann gegen konfigurierte Fuzzy-Server beziehungsweise eigene Fuzzy-Storages prüfen. Auf meinem System war der rspamd.com-Fuzzy als externer, schreibgeschützter Server eingebunden:
rspamd.com
read_only = true
Für eigene bestätigte Phishing-Mails benötigt man dagegen einen eigenen Fuzzy-Storage. Rspamd besitzt dafür bereits einen Fuzzy-Worker; dieser ist standardmäßig deaktiviert und kann lokal über worker-fuzzy.inc aktiviert werden. Der Standardport des Fuzzy-Workers ist 11335.
Für einen einzelnen Mailserver reicht ein lokaler Worker beispielsweise auf:
127.0.0.1:11335Der externe, schreibgeschützte Fuzzy-Server muss dadurch nicht ersetzt werden. Beide können parallel betrieben werden:
                    Rspamd
                      │
          ┌───────────┴───────────┐
          │                       │
          ▼                       ▼
  rspamd.com Fuzzy        lokaler Fuzzy
      read-only              Storage
                                 │
                                 ▼
                              Flag 11
                                 │
                                 ▼
                      LOCAL_FUZZY_PHISH
Auf meinem System wurde der lokale Storage mit SQLite betrieben. Für einen kleinen privaten Mailserver ist das völlig ausreichend; ein zusätzlicher Redis-Backend-Layer wäre hier unnötige Komplexität.
HTML-Fuzzy muss in eigenen Regeln bewusst aktiviert werden
Die Fähigkeit von Rspamd zu HTML-Fuzzy bedeutet nicht automatisch, dass jede eigene Fuzzy-Regel HTML-Strukturen verwendet. Für eine eigene Regel muss HTML-Shingling entsprechend aktiviert werden.
Der in meinem Rspamd-4.1.5-Setup funktionierende Ausschnitt sieht beispielsweise so aus:
html_shingles = true;
min_html_tags = 15;

text_shingles = true;
min_length = 32;
Rspamd prüft außerdem, ob eine Nachricht überhaupt genügend HTML-Struktur besitzt, damit ein sinnvoller struktureller Vergleich möglich ist. Eine triviale Mail wie
<p>Hello</p>liefert naturgemäß weniger verwertbare Struktur als ein vollständiges Newsletter- oder Login-Template.
Im Test wurde nach dem Einlernen einer echten ELSTER-Phishing-Mail anschließend ausdrücklich ein HTML-Treffer sichtbar:
LOCAL_FUZZY_PHISH (11.90)
[11:731babfa42:1.00:html]
Damit war nicht nur der lokale Fuzzy-Storage bestätigt, sondern auch der HTML-Pfad selbst.
Lerngewicht und Treffergrenze müssen zusammenpassen
Eine praktische Stolperfalle zeigte sich beim ersten Test des lokalen Storages. Die Mail ließ sich erfolgreich mit
rspamc -f 11 -w 10 fuzzy_add /pfad/zur/maileinlernen und der Storage bestätigte die Operation mit success = true. Trotzdem erschien anschließend zunächst kein Fuzzy-Symbol.
Die Ursache lag nicht am Storage, sondern an der konfigurierten Schwelle. Das Lerngewicht betrug 10, während die Regel zunächst einen höheren Grenzwert erwartete.
Das ist ein wichtiger Punkt für die Praxis: Ein erfolgreiches fuzzy_add bedeutet nicht automatisch, dass eine Nachricht anschließend einen sichtbaren Treffer auslöst. Lerngewicht, Flag und Schwellenwerte müssen zueinander passen.
Nach Anpassung des Grenzwerts wurde der HTML-Fuzzy-Treffer korrekt sichtbar.
Kontrolliertes Lernen statt automatischem Spam-Training
Ein eigener Fuzzy-Storage ist nur so gut wie seine Trainingsdaten. Eine Nachricht, die ein Benutzer als Spam markiert, ist nicht automatisch Phishing. Newsletter, Werbung oder unerwünschte legitime Mails blind in einen Phishing-Fuzzy-Storage zu übernehmen wäre deshalb gefährlich.
Auf meinem System erfolgt das Lernen nur für manuell bestätigte Phishing-Mails. Dafür existiert ein kleines Hilfsscript:
rspamd-fuzzy-learn-phish /pfad/zur/mailDer Ablauf ist bewusst einfach:
Mail prüfen
   │
   ▼
Phishing bestätigt
   │
   ▼
fuzzy_add mit Flag 11
   │
   ▼
lokaler Fuzzy Storage
   │
   ▼
erneuter Scan zur Kontrolle
Der komplette Spam-Ordner wird ausdrücklich nicht automatisch gelernt.
Gerade auf einem privaten Mailserver ist dieser kontrollierte Ansatz sinnvoller als eine komplexe automatische Feedback-Pipeline. Die Anzahl tatsächlich relevanter Phishing-Mails ist überschaubar und False Positives im Fuzzy-Storage lassen sich so wesentlich besser vermeiden.
Ein Fuzzy-Treffer ist kein Wahrheitsdetektor
Auch ein korrekt arbeitender Fuzzy-Storage macht aus einem Match kein binäres „Spam“ oder „Ham“. Fuzzy-Hashes besitzen Gewichtungen, und nicht exakte Shingle-Matches haben eine Ähnlichkeit beziehungsweise Wahrscheinlichkeit.
Rspamd 4.1.3 hat die Bewertung solcher nicht exakten Treffer überarbeitet und zusätzlich eine strukturierte Fuzzy-Diagnostik eingeführt. task:get_fuzzy_results() kann unter anderem Regel, Symbol, Storage, Digest, Match-Typ, Wahrscheinlichkeit, Score, Flag und Zeitstempel eines Treffers liefern. Gerade bei False-Positive-Analysen ist diese Nachvollziehbarkeit wertvoll.
Das ist auch konzeptionell wichtig: Ein schwacher struktureller Match sollte nicht denselben Einfluss auf die Gesamtentscheidung erhalten wie eine nahezu identische Nachricht.
Vorsicht mit eigenen DKIM- und Envelope-From-Regeln
Während der Umsetzung zeigte sich noch eine zweite wichtige False-Positive-Quelle, die mit HTML-Fuzzy zunächst gar nichts zu tun hatte.
Eine eigene Regel wertete folgende Kombination als DKIM_ALIGNMENT_FAIL:
R_DKIM_ALLOW & FROM_NEQ_ENVFROMDas klingt zunächst plausibel, ist aber fachlich zu grob. Bei legitimen Drittversendern ist es völlig normal, dass der sichtbare From und der Envelope-From unterschiedliche Domains verwenden.
Im Test trat das bei mehreren legitimen Mails auf: Findora versendete über Apex Timing, AREX über Mailchimp und German Operator über Shopify. In allen Fällen war die sichtbare From-Domain korrekt DKIM-signiert und DMARC erfolgreich, während die Bounce- beziehungsweise Envelope-Domain vom Versanddienstleister stammte.
Ein typisches Muster sieht so aus:
From:
growth@firma.example

Envelope-From:
bounce-123@mailchimp.example

DKIM:
pass für firma.example

DMARC:
pass für firma.example
FROM_NEQ_ENVFROM allein ist damit kein Beweis für fehlendes DKIM-Alignment und schon gar kein Phishing-Beweis.
Die Regel wurde deshalb so angepasst, dass ein erfolgreicher DMARC-Abgleich berücksichtigt wird:
R_DKIM_ALLOW
&
FROM_NEQ_ENVFROM
&
!DMARC_POLICY_ALLOW
Auch eine aggressive PHISH_CORE-Regel wurde entsprechend entschärft. Zuvor konnte bereits die Kombination aus abweichendem Envelope-From und einem Spamhaus-XBL-Treffer auf einer Received-IP acht zusätzliche Punkte erzeugen, obwohl DMARC erfolgreich war.
Dieser Praxispunkt ist wichtig: Eigene Phishing-Composites dürfen bestehende Authentisierungsergebnisse nicht ignorieren. Gerade Mailchimp, Shopify, CRM-Systeme, Newsletter-Dienste und Buchungsplattformen verwenden regelmäßig abweichende Return-Path- oder Bounce-Domains.
Versteckter Text und CSS-Evasion
Phishing- und Spamkampagnen versuchen nicht nur, URLs oder Templates zu verschleiern. Eine weitere Technik ist unsichtbarer Text, der statistische Filter beeinflussen soll.
Ein vereinfachtes Beispiel:
<div style="position:absolute; left:-10000px">
    harmless newsletter meeting invoice project customer
</div>
Rspamd 4.1.1 hat die Erkennung verschiedener CSS-Hiding-Techniken erweitert, darunter Off-Screen-Positionierung, Clipping, negativer text-indent, bestimmte Sichtbarkeitseigenschaften und sehr kleine Schriftgrößen. Rspamd wird dadurch nicht zu einer vollständigen Browser-Engine, kann aber bestimmte Manipulationen der sichtbaren beziehungsweise unsichtbaren Textdarstellung besser erkennen.
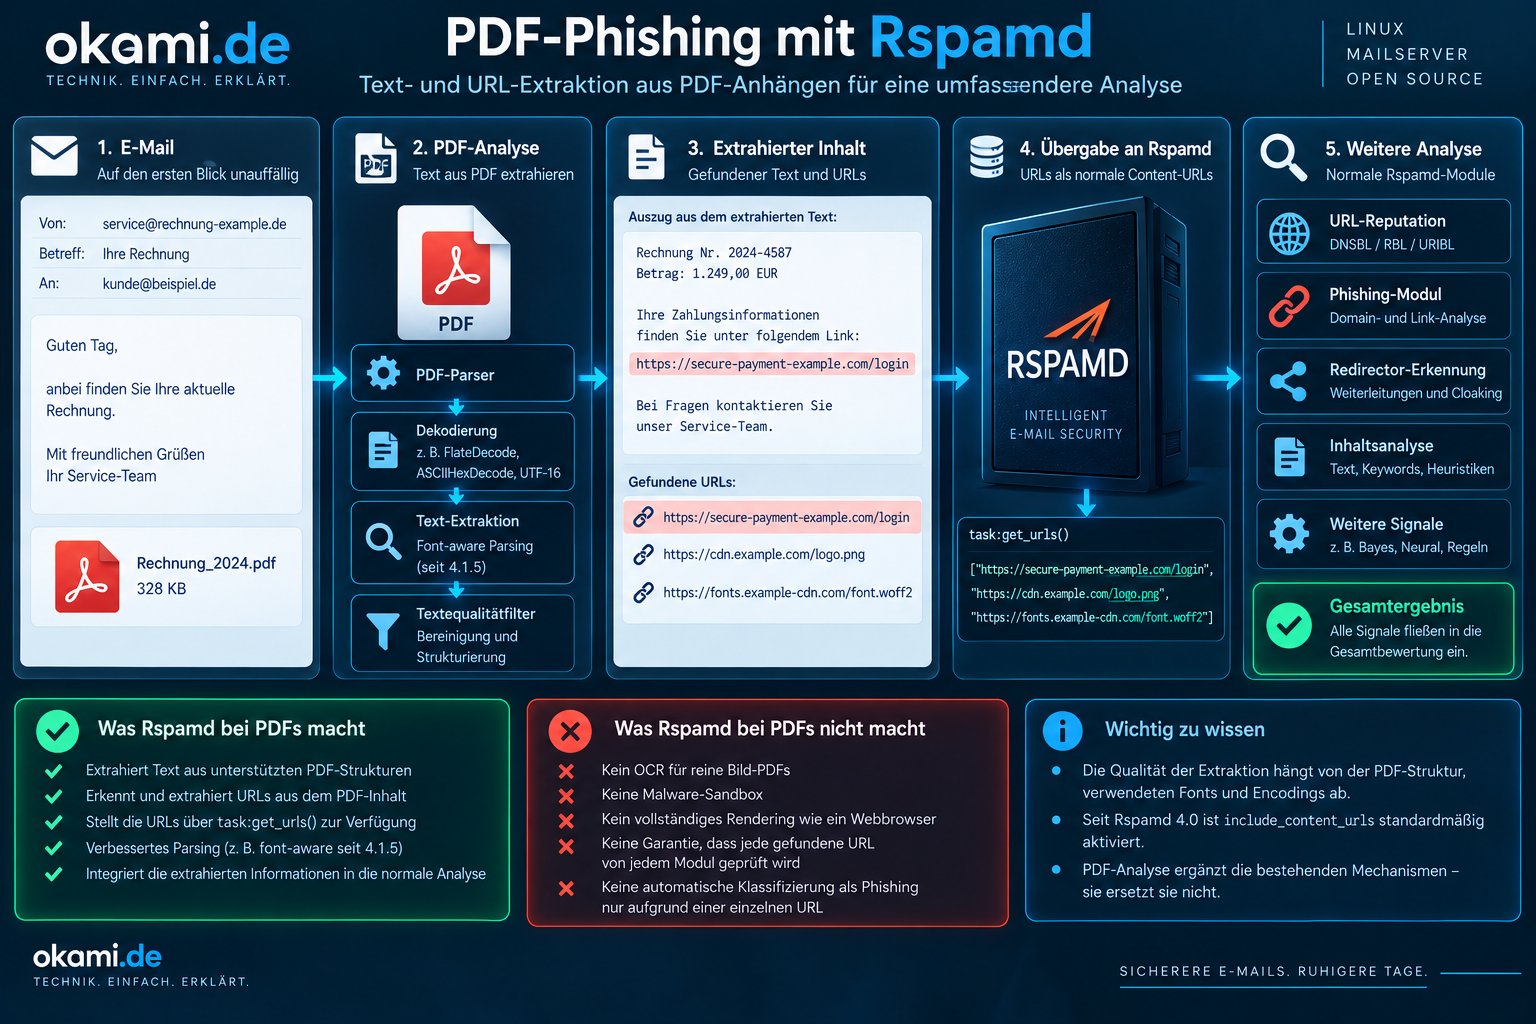
PDF-Phishing: interessant, aber weniger deterministisch als gedacht
Ein weiteres Angriffsszenario verlagert die eigentliche Aktion in einen PDF-Anhang. Die Mail selbst kann relativ harmlos aussehen:
Betreff: Neue Rechnung

Guten Tag,

Ihre aktuelle Rechnung finden Sie im Anhang.
Im PDF befindet sich anschließend möglicherweise eine gefälschte Rechnung, ein Logo und ein Link auf eine externe Webseite.
Rspamd 3.14.3 führte eine grundlegende PDF-Textextraktion ein. Rspamd 4.1.5 hat diesen Parser noch einmal deutlich erweitert und kann unter anderem PDF-Fontdefinitionen, Encodings, Differences, /ToUnicode-CMaps und Composite Fonts stärker berücksichtigen.
Wichtig ist allerdings, diesen Mechanismus nicht zu überschätzen.
Rspamd ist kein vollständiger PDF-Renderer, kein Browser und kein OCR-System. Es versucht, aus unterstützten PDF-Strukturen verwertbare Inhalte zu extrahieren. Ob das bei einem konkreten Dokument gelingt, hängt erheblich davon ab, wie dieses PDF aufgebaut wurde.
Content-URLs aus PDFs sind standardmäßig aktiviert
Seit Rspamd 4.0 steht include_content_urls standardmäßig auf true. URLs, die Rspamd aus PDF- oder anderen berechneten Content-Parts tatsächlich erzeugt, können dadurch standardmäßig über task:get_urls() in die weitere URL-Verarbeitung gelangen. Ob und durch welche Module oder DNSBLs sie anschließend geprüft werden, hängt von der jeweiligen Konfiguration ab. Wer das alte Verhalten wiederherstellen möchte, müsste include_content_urls = false explizit setzen.
Auf meinem System wurde die Option zusätzlich explizit gesetzt:
include_content_urls = true;Auch die MIME-Konfiguration erkannte PDF korrekt:
pdf [
    "application/octet-stream",
    "application/pdf",
    "application/x-pdf",
]
Damit war eindeutig: PDF-Erkennung und Content-URL-Unterstützung waren nicht einfach deaktiviert.
Trotzdem ließen sich mit mehreren Test-PDFs keine URL-Treffer reproduzieren. Weder ein reales PDF noch künstlich erzeugte Test-PDFs lieferten über rspamadm mime urls eine verwertbare URL, obwohl eine Testdatei sogar eine explizite PDF-Link-Annotation enthielt.
Genau hier liegt die wichtige praktische Einschränkung.
Die Verarbeitungskette lautet nicht zwingend:
PDF
 ↓
URL
 ↓
task:get_urls()
sondern eher:
PDF
 ↓
Rspamd PDF Parser
 ↓
unterstützte Content-/Textextraktion
 ↓
eventuell erkannte Content-URL
 ↓
task:get_urls()
 ↓
weitere URL-basierte Prüfungen
include_content_urls = true bedeutet also nicht, dass jede sichtbare oder klickbare URL aus jedem PDF garantiert als Rspamd-URL erscheint. Die Option sorgt dafür, dass erkannte Content-URLs nicht anschließend ausgefiltert werden. Sie garantiert aber nicht, dass der PDF-Parser aus jeder Dokumentstruktur überhaupt eine solche URL erzeugt.
Dieser Unterschied ist wichtig und war in der ursprünglichen Betrachtung zu optimistisch dargestellt.
Was Rspamd bei PDFs nicht macht
Rspamds PDF-Verarbeitung ist kein OCR. Besteht ein PDF ausschließlich aus eingescannten Bildern und besitzt keine verwertbare Textebene, gewinnt Rspamd daraus nicht automatisch denselben Inhalt wie ein OCR-System.
Ebenso ersetzt die PDF-Inhaltsanalyse keine Malware-Sandbox. Ein verdächtiges Dokument wird nicht in einer isolierten Umgebung ausgeführt, und eine gefundene URL wird nicht automatisch wie in einem Browser geöffnet und vollständig gerendert.
Für Malware-Analyse, OCR und dynamische Webanalyse bleiben deshalb separate Werkzeuge erforderlich.
Text-, HTML- und Attachment-Fuzzy sind unterschiedliche Dinge
Auch beim Begriff Fuzzy Hashing lohnt sich eine saubere Trennung. Für Text werden Shingles verwendet, um ähnliche Texte trotz kleiner Änderungen vergleichen zu können. HTML besitzt einen eigenen strukturellen Fuzzy-Pfad, bei dem DOM-Struktur und Domains eine größere Rolle spielen. Andere Inhalte können dagegen über exaktere Digests beziehungsweise andere Hash-Verfahren behandelt werden.
Ein „Fuzzy Match“ bezeichnet deshalb nicht immer denselben technischen Mechanismus.
Diese Unterscheidung wird insbesondere dann wichtig, wenn ein Treffer analysiert oder ein eigener Fuzzy-Storage aufgebaut wird.
Die Mechanismen ergänzen sich
Keiner der beschriebenen Mechanismen ersetzt die anderen.
Eine moderne Rspamd-Installation kann gleichzeitig Informationen aus verschiedenen Ebenen verwenden:
                     eingehende Mail
                           │
          ┌────────────────┼────────────────┐
          │                │                │
          ▼                ▼                ▼
     SPF/DKIM/DMARC    Reputation       Inhalt
                                             │
                          ┌──────────────────┼───────────────┐
                          │                  │               │
                          ▼                  ▼               ▼
                       HTML                CTA              PDF
                          │                  │               │
                    HTML-Fuzzy        Brand-Domain       Content/
                          │              Vergleich        Text
                          │                  │               │
                          ▼                  ▼               ▼
                 lokaler/public       PHISH_BRAND_CTA    mögliche
                    Fuzzy Store                         Content-URLs
                          │                  │               │
                          └──────────┬───────┴───────────────┘
                                     │
                                     ▼
                              weitere Signale
                                     │
                           ┌─────────┴─────────┐
                           │                   │
                         Bayes               Neural
                           │                   │
                           └─────────┬─────────┘
                                     │
                                     ▼
                              Gesamtbewertung
Genau diese Kombination ist entscheidend.
Eine neue Phishing-Kampagne besitzt möglicherweise noch keinen bekannten Fuzzy-Hash, zeigt aber eine bekannte Marke mit einer völlig unpassenden CTA-Domain. Eine andere Kampagne verwendet eine etablierte oder kompromittierte Domain, kopiert dafür aber ein bereits bekanntes HTML-Template. Wieder eine andere Nachricht wird hauptsächlich durch Reputation, Authentisierungsfehler oder Bayes auffällig.
Jede dieser Ebenen beantwortet eine andere Frage.
Grenzen von HTML-Fuzzy
HTML-Fuzzy bleibt ein Vergleichssystem. Ein völlig neues Phishing-Template ohne passende Vergleichsdaten kann nicht allein dadurch erkannt werden, dass der Fuzzy-Mechanismus aktiviert ist.
Auch CTA-Erkennung ist heuristisch. Nicht jede denkbare Button-Konstruktion wird zwangsläufig als CTA identifiziert, und ein vollständig neues HTML-Layout kann trotz identischer Marke und ähnlicher Angriffsidee keinen Fuzzy-Match erzeugen.
Genau das zeigte der ELSTER-Test: Die erste Phishing-Mail wurde erfolgreich eingelernt und anschließend als HTML-Fuzzy erkannt. Die zweite ELSTER-Mail löste diesen Treffer nicht aus, obwohl sie ebenfalls Phishing war.
Die zusätzliche Brand-CTA-Regel erkannte dagegen die Diskrepanz zwischen „ELSTER“ und einer Amazon-S3-Domain.
Das zeigt sehr gut, warum Fuzzy nicht als alleiniger Phishing-Detektor betrachtet werden sollte.
Was ich aus der praktischen Umsetzung mitgenommen habe
Die eigentliche Stärke von Rspamd liegt nicht darin, eine einzelne besonders intelligente Phishing-Funktion zu besitzen. Interessanter ist die Möglichkeit, verschiedene Signale miteinander zu kombinieren.
HTML-Fuzzy kann bekannte Strukturen wiedererkennen. CTA-Erkennung kann den handlungsrelevanten Link stärker gewichten. Eine Brand-zu-Domain-Zuordnung kann prüfen, ob ein Ziel überhaupt zur behaupteten Marke passt. SPF, DKIM und DMARC liefern Identitäts- und Authentisierungssignale. Reputation, Bayes und Neural Networks betrachten wiederum andere Eigenschaften.
Gleichzeitig hat die Umsetzung gezeigt, wie schnell selbst gut gemeinte eigene Regeln False Positives erzeugen können. Eine unterschiedliche Envelope-From-Domain ist bei Drittversendern normal. Ein erfolgreicher DMARC-Abgleich sollte deshalb nicht ignoriert werden. Ein Fuzzy-Storage braucht kontrollierte Trainingsdaten. Und eine theoretisch vorhandene PDF-Funktion bedeutet nicht automatisch, dass jede PDF-Struktur in der Praxis gleich gut analysiert wird.
Genau diese Grenzen machen die Konfiguration interessanter als eine einfache Feature-Liste.
Fazit
HTML-Fuzzy, CTA-Analyse, Brand-Domain-Abgleich und PDF-Inhaltsanalyse erweitern Rspamd um wertvolle zusätzliche Signale. Sie machen den Spamfilter aber nicht zu einem automatischen Phishing-Detektor, der jeden Angriff zuverlässig erkennt.
Auf meinem System hat sich insbesondere die Kombination aus lokalem HTML-Fuzzy und einer zusätzlichen Brand-CTA-Prüfung als interessant erwiesen. Ein bekanntes HTML-Template kann über Fuzzy wiedererkannt werden. Eine unbekannte Template-Variante kann trotzdem auffallen, wenn eine bekannte Marke plötzlich auf eine völlig fremde Domain verweist.
Der lokale Fuzzy-Storage bleibt dabei bewusst kontrolliert. Nur bestätigte Phishing-Mails werden eingelernt. Der externe rspamd.com-Fuzzy bleibt parallel aktiv.
Bei PDF-Anhängen ist dagegen eine realistischere Erwartung notwendig. Rspamd 4.1.5 besitzt einen deutlich verbesserten PDF-Parser und Content-URLs sind seit Rspamd 4.0 standardmäßig aktiviert. Ob aus einem konkreten PDF tatsächlich eine verwertbare URL entsteht, hängt aber von dessen interner Struktur und den Fähigkeiten des Parsers ab. Genau dieser praktische Unterschied zwischen „Feature vorhanden“ und „für jedes Dokument zuverlässig reproduzierbar“ sollte bei der Bewertung nicht verloren gehen.
Die Stärke von Rspamd entsteht am Ende deshalb nicht aus einer einzelnen Regel, sondern aus dem Zusammenspiel vieler unabhängiger Signale. Eine Mail kann strukturell bekannt wirken, eine Marke imitieren, eine ungewöhnliche CTA-Domain verwenden, aus einem auffälligen Netz kommen oder Authentisierungsprobleme zeigen. Je besser diese Informationen gegeneinander geprüft werden, desto schwieriger wird es für Phishing-Mails, sich nur durch den Austausch eines einzelnen Merkmals an der Erkennung vorbeizuschieben.
Quellen und weiterführende Dokumentation
Für diesen Artikel wurden insbesondere die offiziellen Rspamd-Changelogs und die Rspamd-Dokumentation zu Fuzzy Checks, Fuzzy Storage, HTML-/CTA-Verarbeitung, Phishing und MIME/PDF-Verarbeitung verwendet. Relevant sind vor allem Rspamd 3.14.0 für HTML-Fuzzy und CTA-Verarbeitung, 3.14.3 für PDF-Textextraktion, 4.0.0 vom 30. März 2026 für dual-mode HTML-Fuzzy und standardmäßig aktivierte Content-URLs sowie 4.1.3 und 4.1.5 für Fuzzy-Diagnostik und Verbesserungen der PDF-Textextraktion.