Wie sich mit aktueller Hardware eine lokale KI-Plattform für kleinere Unternehmen aufbauen lässt – von der Modellinferenz über eigene Wissensbestände und Bildgenerierung bis hin zu Werkzeugen, Agenten und einem kontrollierbaren Systembetrieb.
Wer heute ein Sprachmodell auf seinem Rechner betreiben möchte, hat es vergleichsweise einfach. Ollama installieren, ein Modell herunterladen und wenige Minuten später steht ein lokaler Chat zur Verfügung. Auch die Bildgenerierung lässt sich mit überschaubarem Aufwand einrichten. Schwieriger wird es, sobald mehrere dieser Funktionen zusammenarbeiten sollen. Ein Sprachmodell soll auf eigene Dokumente zugreifen, aktuelle Informationen recherchieren, Bilder erzeugen, Programme aufrufen oder wiederkehrende Aufgaben selbstständig abarbeiten. Spätestens an diesem Punkt reicht es nicht mehr, einige Anwendungen nebeneinander zu installieren.
Die technischen Voraussetzungen haben sich in den vergangenen Jahren erheblich verbessert. Leistungsfähige Grafikkarten verfügen mittlerweile über ausreichend Speicher, um Sprachmodelle mit mehreren Milliarden Parametern lokal auszuführen. Quantisierte Modelle reduzieren den Speicherbedarf, während optimierte Inferenzverfahren die Ausführungsgeschwindigkeit verbessern. Gleichzeitig stehen für Bild- und Videogenerierung Modelle zur Verfügung, die nicht mehr ausschließlich auf großen GPU-Clustern betrieben werden müssen. Was vor wenigen Jahren noch aufwendige Spezialhardware erforderte, lässt sich inzwischen zumindest teilweise mit einer gut ausgestatteten Workstation realisieren.
Damit sind allerdings nicht sämtliche technischen Schwierigkeiten beseitigt. Sprachmodelle, Embeddings, Bildgeneratoren und Videomodelle konkurrieren um denselben Grafikspeicher. Hinzu kommen Datenbanken, Schnittstellen, Benutzerverwaltung und die Frage, wie ein solches System aktualisiert, gesichert und im Fehlerfall wiederhergestellt werden kann. Bei mehreren gleichzeitigen Benutzern verschärfen sich diese Anforderungen zusätzlich, weil nicht mehr nur die maximale Modellgröße, sondern auch die Verteilung der verfügbaren Rechenleistung eine Rolle spielt.
Für kleinere Unternehmen und Agenturen stellt sich deshalb weniger die Frage, ob lokale KI grundsätzlich funktioniert. Interessanter ist, wie sich aus den verfügbaren Komponenten ein System aufbauen lässt, das auch nach der ersten erfolgreichen Installation zuverlässig arbeitet, sich erweitern lässt und dessen technischer Zustand nachvollziehbar bleibt.
1. Lokale KI ist mehr als ein Sprachmodell
Die ersten lokal nutzbaren Sprachmodelle waren vor allem ein Experimentierfeld. Modelle mussten teilweise manuell konvertiert werden, die GPU-Unterstützung funktionierte nicht immer zuverlässig und größere Kontextfenster führten schnell zu Speicherproblemen. Mit Projekten wie llama.cpp und später Ollama änderte sich die Situation erheblich. Modelle ließen sich zunehmend unkompliziert herunterladen, über standardisierte Schnittstellen ausführen und in andere Anwendungen integrieren. Damit war zunächst ein grundlegendes Problem gelöst: Die eigentliche Textgenerierung musste nicht mehr zwangsläufig über einen externen Dienst erfolgen. Für viele Aufgaben genügt heute eine geeignete Workstation oder ein kleiner GPU-Server.
Ein Sprachmodell allein besitzt allerdings weder einen zuverlässigen Zugriff auf Unternehmensdokumente noch die Fähigkeit, selbstständig Anwendungen zu bedienen. Es kann Texte erzeugen und mit den Informationen arbeiten, die während des Trainings erlernt oder im aktuellen Kontext bereitgestellt wurden. Soll es beispielsweise einen Vertrag mit internen Richtlinien vergleichen, aktuelle Informationen im Internet recherchieren oder eine Datei auf einem Netzlaufwerk bearbeiten, benötigt es zusätzliche Funktionen. Diese müssen Informationen beschaffen, aufbereiten und gegebenenfalls Aktionen außerhalb der eigentlichen Modellinferenz ausführen.
Die einzelnen Aufgaben werden von unterschiedlichen technischen Komponenten übernommen. Ein Retrieval-System erschließt Dokumente, eine Suchmaschine liefert externe Informationen und eine Werkzeugschicht stellt Funktionen des Betriebssystems oder anderer Anwendungen bereit. Bild- und Videogenerierung verwenden wiederum eigene Modelle und Ausführungsumgebungen, deren Anforderungen sich deutlich von denen klassischer Sprachmodelle unterscheiden. Aus der ursprünglich einfachen Modellinferenz wird damit eine kleine Anwendungsplattform, deren Bestandteile zwar auf demselben Rechner ausgeführt werden können, technisch aber weitgehend unabhängig voneinander arbeiten sollten.
Gerade diese Trennung macht einen lokalen KI-Stack langfristig interessant. Ein Sprachmodell lässt sich austauschen, ohne die Dokumentensammlung erneut aufzubauen, sofern Embedding-Modell und Retrieval-Pipeline unverändert bleiben. Eine neue Bildgenerierungsruntime kann hinzukommen, ohne dass die Benutzerverwaltung angepasst werden muss, und zusätzliche Werkzeuge lassen sich über definierte Schnittstellen anbinden, statt sie unmittelbar in die Chatoberfläche einzubauen. Die eigentliche Aufgabe besteht deshalb weniger darin, möglichst viele KI-Anwendungen zu installieren, sondern ihre Zuständigkeiten sauber voneinander abzugrenzen.
2. Architektur: mehrere Dienste auf einem Rechner
Bei einem lokalen KI-Stack ist es zunächst verlockend, sämtliche Komponenten in einer Anwendung unterzubringen. Für einen einfachen Arbeitsplatz mit einem einzigen Sprachmodell kann das durchaus ausreichen. Sobald mehrere Funktionen dauerhaft zusammenarbeiten sollen, führt dieser Ansatz allerdings zu unnötigen Abhängigkeiten. Aktualisiert man die Oberfläche, ändern sich unter Umständen gleichzeitig Einstellungen der Modellruntime oder der Dokumentenverarbeitung. Soll später eine andere Suchmaschine oder ein zusätzlicher Bildgenerator verwendet werden, müssen möglicherweise Teile der gesamten Anwendung ersetzt werden.
Eine zweckmäßige Architektur besteht deshalb aus mehreren logisch getrennten Ebenen. Die oberste Ebene bildet die Benutzeroberfläche, über die Mitarbeiter mit dem System arbeiten. Darunter befindet sich eine Steuerungsschicht, die Anfragen entgegennimmt, an die zuständigen Dienste weiterleitet und gegebenenfalls mehrere Arbeitsschritte koordiniert. Die eigentliche Berechnung übernehmen spezialisierte Runtimes für Sprachmodelle sowie Bild- und Videomodelle. Daneben stehen Dienste für Dokumentenverarbeitung, Wissenssuche und externe Recherche, während eine weitere Ebene Werkzeuge für den Zugriff auf Dateien, Anwendungen oder Betriebssystemfunktionen bereitstellt.
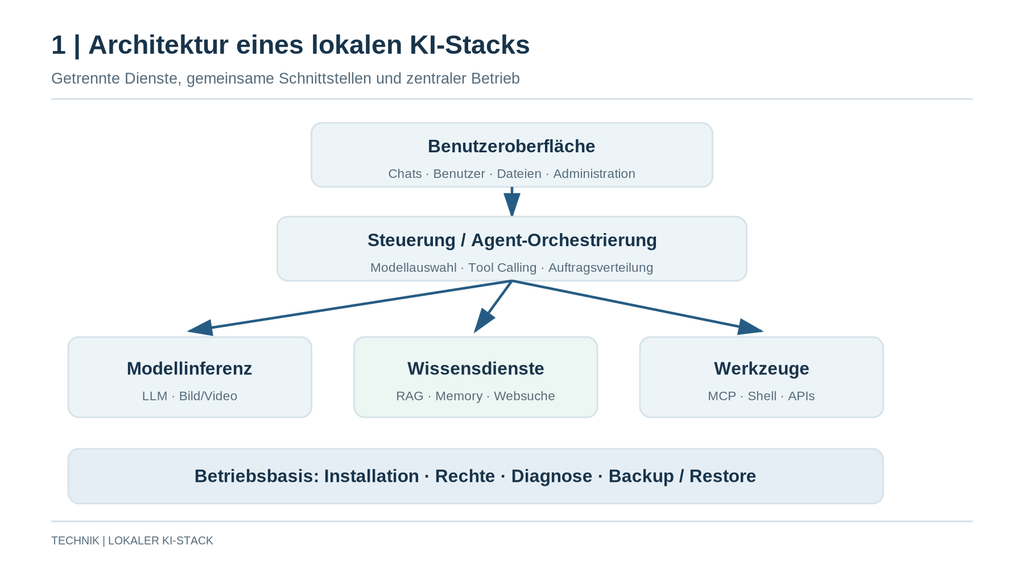
Abbildung 1: Logischer Aufbau eines lokalen KI-Stacks
Die logischen Dienste können auf einem einzigen Rechner laufen. Die Trennung verhindert, dass ein Austausch einzelner Modelle oder Anwendungen zwangsläufig Änderungen an der gesamten Plattform erfordert.
Die technische Grundlage dieser Architektur bildet der Systembetrieb. Prozesse müssen gestartet und überwacht, Konfigurationen verwaltet, Daten gesichert und Änderungen nachvollziehbar durchgeführt werden. Diese Aufgaben werden häufig erst berücksichtigt, wenn die eigentlichen KI-Funktionen bereits eingerichtet sind. Gerade bei einem Rechner, der von mehreren Mitarbeitern genutzt wird, sollten sie jedoch von Anfang an Bestandteil der Planung sein.
Eine solche Architektur benötigt nicht zwangsläufig Virtualisierung oder einen Kubernetes-Cluster. Für einen einzelnen Rechner reichen häufig native Dienste, isolierte Python-Umgebungen und einige Container aus. Unter Windows kann WSL2 Linux-basierte Komponenten bereitstellen, während sich unter Linux dieselben Dienste meist unmittelbar betreiben lassen. Die Entscheidung für ein Betriebssystem sollte deshalb vor allem davon abhängen, welche Anwendungen und Administrationswerkzeuge bereits vorhanden sind und wie die Plattform später betrieben werden soll.
Wichtig ist eine einheitliche Schnittstellenstrategie. Die Steuerung sollte möglichst über dokumentierte HTTP-APIs und klar definierte Werkzeugaufrufe erfolgen. Interne Datenbanken direkt aus fremden Komponenten heraus zu verändern oder Anwendungen über improvisierte Dateizugriffe miteinander zu verbinden, mag kurzfristig funktionieren, erschwert aber Updates erheblich. Definierte Schnittstellen reduzieren diese Abhängigkeiten und ermöglichen es, einzelne Komponenten zu ersetzen, ohne das Gesamtsystem neu aufbauen zu müssen.
3. Die Hardwarefrage: warum VRAM wichtiger ist als Rechenleistung auf dem Papier
Die Auswahl geeigneter Hardware beginnt bei der Grafikkarte. Zwar können Sprachmodelle grundsätzlich auch auf CPUs ausgeführt werden, für eine interaktive Nutzung größerer Modelle ist eine GPU aber meistens die sinnvollere Wahl. Entscheidend ist vor allem der verfügbare Grafikspeicher, da sowohl die Modellgewichte als auch verschiedene Zwischenergebnisse während der Inferenz dort abgelegt werden müssen. Die reine Rechenleistung einer GPU ist deshalb nur ein Teil der Betrachtung.
Ein Modell mit 30 Milliarden Parametern benötigt bei einer Speicherung mit 16 Bit theoretisch bereits rund 60 Gigabyte für die Gewichte. Bei einer Quantisierung auf vier Bit sinkt dieser reine Gewichtsbedarf rechnerisch auf ungefähr 15 Gigabyte. Hinzu kommen allerdings Metadaten, die tatsächliche Quantisierungsstruktur, Laufzeitpuffer und der Speicher für den Kontext. Die Rechnung zeigt, warum Quantisierung für lokale KI so wichtig geworden ist. Ein Modell, das ursprünglich nur auf teurer Serverhardware betrieben werden konnte, passt durch eine reduzierte Zahlendarstellung möglicherweise auf eine Grafikkarte mit 24 oder 32 Gigabyte VRAM.
Allerdings ist Quantisierung keine verlustfreie Kompression. Je nach Modell, Verfahren und Präzision können sich Genauigkeit, Sprachqualität und die Zuverlässigkeit strukturierter Ausgaben verändern. Vier Bit sind deshalb keine universell richtige Einstellung. Bei Aufgaben, die eine hohe Genauigkeit erfordern, kann eine höhere Präzision sinnvoll sein, während bei einfachen Textverarbeitungsaufgaben ein stärker quantisiertes Modell möglicherweise ausreichend gute Ergebnisse liefert. Die konkrete Entscheidung sollte anhand der vorgesehenen Arbeitslast und nicht ausschließlich anhand des verfügbaren Speichers erfolgen.
Ein weiterer Speicherverbraucher ist der sogenannte KV-Cache. Während der Textgenerierung speichert das Modell Zwischenergebnisse der Attention-Berechnung, damit bereits verarbeitete Token nicht bei jedem Schritt vollständig erneut berechnet werden müssen. Mit wachsendem Kontext steigt dieser Speicherbedarf. Architekturmerkmale wie Grouped Query Attention und Verfahren zur KV-Cache-Quantisierung beeinflussen seine Größe erheblich. Damit erklärt sich auch, weshalb ein Modell bei einem Kontextfenster von 8192 Token problemlos läuft, bei 65536 Token aber plötzlich Speicherprobleme verursacht.
Für einen lokalen KI-Server sollte die Hardware daher nicht ausschließlich anhand der Modellparameter ausgewählt werden. Ein Unternehmen, das überwiegend kurze Texte verarbeitet, benötigt andere Ressourcen als eine Arbeitsgruppe, die umfangreiche Dokumentationen analysiert und mehrere Benutzer gleichzeitig bedient. Bei sehr langen Kontexten oder parallelen Anfragen kann der zusätzliche Speicherbedarf erheblich sein, selbst wenn die eigentlichen Modellgewichte unverändert bleiben.
| Hardwareklasse | Sinnvoller Einsatz |
|---|---|
| 12–16 GB VRAM | Kleinere Sprachmodelle, RAG, Bildgenerierung mit Einschränkungen |
| 24–32 GB VRAM | Größere quantisierte Modelle, anspruchsvollere RAG- und Agentenaufgaben, Bild- und ausgewählte Videoworkflows |
| 48–96 GB VRAM | Größere Modelle, umfangreichere Kontexte, mehr Spielraum für parallele Inferenz |
| Mehrere GPUs | Höhere Modellkapazität oder parallele Lasten, sofern Runtime und Datenübertragung dafür ausgelegt sind |
Diese Einteilung ist bewusst keine Leistungsgarantie. Zwei Grafikkarten mit derselben VRAM-Kapazität können aufgrund ihrer Speicherbandbreite, Architektur und Softwareunterstützung sehr unterschiedliche Ergebnisse liefern. Auch die Anzahl paralleler Benutzer wirkt sich erheblich auf den Bedarf aus. Bei einem einzelnen Arbeitsplatz kann eine Karte mit 24 oder 32 Gigabyte bereits umfangreiche Möglichkeiten eröffnen, während dieselbe Hardware bei fünf gleichzeitig arbeitenden Benutzern deutlich früher an ihre Grenzen stößt.
Für den restlichen Rechner sind ausreichend Arbeitsspeicher und schnelle SSDs sinnvoll. Modelle mit mehreren Gigabyte werden häufig geladen oder gewechselt. Das gilt insbesondere dann, wenn dieselbe GPU abwechselnd Sprach-, Bild- und Videomodelle ausführt. Der Hauptspeicher sollte außerdem groß genug sein, um Betriebssystem, Datenbanken, Dokumentenverarbeitung und mögliche CPU-Offloads ohne ständiges Auslagern auf die SSD zu versorgen. Gerade bei quantisierten großen Modellen kann ein Teil der Gewichte im Arbeitsspeicher verbleiben, wodurch die Anforderungen an dessen Kapazität und Bandbreite steigen.
4. Sprachmodelle: die Runtime ist nicht die Oberfläche
Ein häufiger Fehler beim Aufbau lokaler KI-Systeme besteht darin, die Chat-Anwendung mit der eigentlichen Modellausführung gleichzusetzen. Dabei handelt es sich um zwei unterschiedliche Aufgaben. Die Runtime lädt Modellgewichte, verwaltet Speicher und Kontext, verarbeitet Token und stellt Ergebnisse bereit. Die Oberfläche übernimmt dagegen Gespräche, Benutzerverwaltung, Dateien und die Bedienung. Diese Trennung ist nicht nur eine Frage der Softwarearchitektur, sondern erleichtert später auch die Auswahl und den Austausch von Modellen.
Mit Ollama steht eine relativ einfach zu administrierende lokale Runtime zur Verfügung. Sie übernimmt Modellverwaltung, Download, Ausführung und die Bereitstellung einer API. Für viele Installationen ist das bereits ausreichend, insbesondere wenn die Modelle überwiegend von wenigen Benutzern verwendet werden und die Administration möglichst unkompliziert bleiben soll. Darüber hinaus unterstützt Ollama die Anbindung externer Anwendungen, wodurch die Runtime unabhängig von ihrer eigenen Bedienumgebung genutzt werden kann.
llama.cpp setzt näher an der eigentlichen Inferenz an. Es unterstützt unter anderem GGUF-Modelle, unterschiedliche Quantisierungsverfahren, GPU-Offloading und einen eigenen HTTP-Server. Wer Modellformate, Speicherverhalten oder Runtime-Parameter gezielter kontrollieren möchte, findet hier zahlreiche Möglichkeiten. Die umfangreichen Konfigurationsmöglichkeiten verlangen allerdings auch eine genauere Beschäftigung mit den jeweiligen Modellen und deren technischen Eigenschaften.
Bei größeren Mehrbenutzerinstallationen werden Systeme wie vLLM interessant. Deren Schwerpunkt liegt unter anderem auf einem möglichst effizienten Durchsatz bei parallelen Anfragen. Das ist nicht zwangsläufig die beste Wahl für einen einzelnen Arbeitsplatz, kann bei mehreren gleichzeitig arbeitenden Benutzern aber einen erheblichen Unterschied machen. Die Anforderungen verschieben sich dann von einer möglichst geringen Latenz für eine einzelne Anfrage hin zur effizienten Verarbeitung mehrerer paralleler Arbeitslasten.
Die passende Runtime hängt deshalb weniger vom Namen des jeweiligen Modells ab als von den Anforderungen an den Betrieb. Für einen Arbeitsplatz, auf dem überwiegend eine Person arbeitet, sind einfache Modellverwaltung, geringer Verwaltungsaufwand und nachvollziehbares Kontextverhalten wichtige Kriterien. Bei einem Firmenserver kommen gleichzeitige Sessions, Warteschlangen, Token-Durchsatz und Auslastung hinzu. Auch die Frage, wie Modelle geladen, entladen oder zwischen verschiedenen Benutzern geteilt werden, gewinnt an Bedeutung.
Eine lokale KI-Plattform sollte ihre Anwendungen nach Möglichkeit nicht auf eine einzelne Runtime fest verdrahten. OpenAI-kompatible APIs sind dafür ein praktikabler gemeinsamer Nenner. Vollständige Austauschbarkeit garantieren sie allerdings nicht: Tool Calling, strukturierte Ausgaben, Kontextparameter und multimodale Inhalte werden von verschiedenen Servern unterschiedlich unterstützt. Vor dem Austausch einer Runtime muss deshalb geprüft werden, ob die benötigten Funktionen tatsächlich in gleicher Weise bereitgestellt werden.
5. Nicht jedes Modell eignet sich für jede Aufgabe
Bei der Modellauswahl wird häufig zu stark auf Parameterzahl und allgemeine Benchmarks geachtet. Für den praktischen Einsatz in einem Unternehmen sind andere Eigenschaften mindestens ebenso relevant. Ein Modell, das hervorragend formuliert, muss nicht zuverlässig JSON erzeugen. Ein Modell, das Programmcode versteht, ist nicht zwangsläufig für die Auswertung deutscher Vertragsdokumente geeignet. Und ein Modell mit guten allgemeinen Testergebnissen kann beim mehrstufigen Aufruf externer Werkzeuge erhebliche Schwierigkeiten haben.
Für einen lokalen KI-Stack bietet es sich deshalb an, mehrere Modellklassen zu unterscheiden. Das allgemeine Sprachmodell übernimmt Unterhaltung, Zusammenfassungen und Textverarbeitung. Ein spezialisiertes Coding-Modell kann bei Softwareentwicklung und Skriptanalyse sinnvoll sein. Kleinere Modelle eignen sich häufig für Klassifizierungen, Extraktion oder einfache Vorverarbeitungsschritte, bei denen der Einsatz eines großen Sprachmodells weder technisch noch wirtschaftlich notwendig wäre.
Ein eigener Modelltyp ist für Embeddings zuständig. Solche Modelle generieren keinen gewöhnlichen Antworttext, sondern Vektorrepräsentationen von Texten. Diese werden später für semantische Suchverfahren verwendet. Auch multimodale Modelle bilden eine eigene Kategorie, weil sie neben Text beispielsweise Bilder verarbeiten können. Ob sie darüber hinaus zuverlässig Werkzeuge aufrufen oder strukturierte Antworten erzeugen, muss separat geprüft werden.
Für Unternehmen ist es häufig sinnvoller, zwei oder drei gut getestete Modelle bereitzustellen als eine große Sammlung, deren tatsächliche Eigenschaften niemand kennt. Jedes zusätzliche Modell benötigt Speicherplatz, muss aktualisiert und hinsichtlich seiner Lizenzbedingungen geprüft werden. Bei einer gemeinsamen Plattform kommt außerdem der Aufwand hinzu, geeignete Standardmodelle für unterschiedliche Aufgaben festzulegen und deren Verhalten über Versionswechsel hinweg zu kontrollieren.
Entscheidend sind reproduzierbare Tests mit realistischen Aufgaben. Dazu gehören deutsche Fachtexte, längere Dokumente, Tool-Aufrufe und Fehlerbehandlung. Modelle sollten nicht nur daran gemessen werden, ob sie die richtige Antwort geben, sondern auch daran, ob sie Unsicherheit erkennen und vorgegebene Ausgabeformate einhalten. Besonders bei automatisierten Arbeitsabläufen kann die Zuverlässigkeit solcher Eigenschaften wichtiger sein als ein geringer Unterschied in einem allgemeinen Benchmark.
6. Eine gemeinsame Bedienoberfläche
Sollen mehrere Mitarbeiter dieselbe lokale Plattform verwenden, wird eine zentrale Oberfläche zweckmäßig. Open WebUI ist ein Beispiel für eine solche Anwendung. Sie bietet Chats, Benutzerverwaltung, Modellanbindung, Dokumentverarbeitung und verschiedene Möglichkeiten zur Integration externer Werkzeuge. Damit lassen sich viele der zuvor beschriebenen Funktionen in einer gemeinsamen Bedienumgebung zusammenführen, ohne dass Benutzer unmittelbar mit den einzelnen Backend-Diensten arbeiten müssen.
Wichtiger als der konkrete Produktname ist die Architekturentscheidung dahinter. Die Oberfläche sollte weder die Modellgewichte selbst verwalten müssen noch direkten Zugriff auf jede interne Datenbank benötigen. Sie übermittelt Anfragen an die zuständige Runtime und erhält Antworten über eine definierte Schnittstelle zurück. Dokumente werden an die Wissensverarbeitung weitergegeben, während Bildaufträge an den entsprechenden Workflow-Dienst gelangen. Auf diese Weise entsteht für den Benutzer der Eindruck einer gemeinsamen Anwendung, obwohl im Hintergrund mehrere spezialisierte Dienste arbeiten.
Diese Trennung erleichtert insbesondere die Wartung. Ein neues Modell kann getestet werden, ohne dass die Chatoberfläche neu installiert werden muss. Eine Runtime lässt sich ersetzen, sofern die benötigten Schnittstellen und Funktionen erhalten bleiben. Ebenso können unterschiedliche Modelle für verschiedene Benutzergruppen freigegeben werden, ohne dass dafür mehrere vollständig getrennte Installationen erforderlich sind.
Allerdings ist eine solche Oberfläche nicht automatisch mandantenfähig oder für beliebig viele parallele Benutzer geeignet. Benutzerrechte, API-Zugänge, Session-Verwaltung und Datenisolation müssen mit Blick auf die konkrete Anwendung geprüft werden. Gerade bei einer gemeinsam genutzten Plattform muss nachvollziehbar sein, wer auf welche Dokumente, Wissensbestände und Werkzeuge zugreifen darf. Die zentrale Oberfläche wird damit auch zu einem wichtigen Bestandteil der Sicherheitsarchitektur.
7. RAG: wenn Unternehmensdokumente durchsuchbar werden
Sprachmodelle kennen nur Informationen, die ihnen beim Training oder während einer Anfrage zur Verfügung gestellt wurden. Interne Verträge, technische Dokumentationen oder projektspezifische Unterlagen gehören normalerweise nicht dazu. Retrieval Augmented Generation, kurz RAG, löst dieses Problem, indem relevante Dokumentpassagen zur Laufzeit gesucht und dem Modell als zusätzlicher Kontext übergeben werden. Das Modell muss dadurch nicht für jede Änderung des internen Wissensbestands erneut trainiert werden.
Der eigentliche Prozess beginnt bereits beim Import der Dokumente. PDF-Dateien, Office-Dokumente und andere Quellen müssen zunächst verarbeitet werden. Dabei entstehen häufig schon die ersten Fehler. Tabellen verlieren ihre Struktur, Spalten werden in falscher Reihenfolge ausgelesen und technische Zeichnungen lassen sich mit reiner Textextraktion nur unvollständig erfassen. Ein RAG-System kann diese Probleme später nicht einfach durch ein größeres Sprachmodell ausgleichen. Was bei der Dokumentverarbeitung falsch erfasst wurde, steht auch für die Suche nicht korrekt zur Verfügung.
Nach der Extraktion werden längere Texte in kleinere Abschnitte zerlegt. Dieses sogenannte Chunking ist notwendig, weil ganze Dokumente für eine effiziente Suche häufig zu umfangreich sind. Die richtige Größe der Abschnitte hängt vom Inhalt ab. Bei Fließtext können größere Abschnitte sinnvoll sein, während bei technischen Dokumentationen Überschriften, Parameter und zugehörige Erläuterungen möglichst zusammenbleiben müssen. Werden diese Zusammenhänge beim Aufteilen zerstört, kann das Retrieval später zwar passende Textstücke finden, dem Modell fehlt aber der für die Interpretation notwendige Kontext.
Anschließend berechnet ein Embedding-Modell für jeden Abschnitt eine Vektorrepräsentation. Diese Vektoren werden gemeinsam mit dem Text und Metadaten wie Dokumentname, Version oder Quelle gespeichert. Stellt ein Benutzer später eine Frage, wird auch diese in einen Suchvektor umgewandelt. Das System ermittelt passende Abschnitte und übergibt sie dem Sprachmodell. Die eigentliche Antwort entsteht weiterhin durch das Sprachmodell, wird nun aber durch gezielt ausgewählte Informationen aus dem eigenen Datenbestand ergänzt.
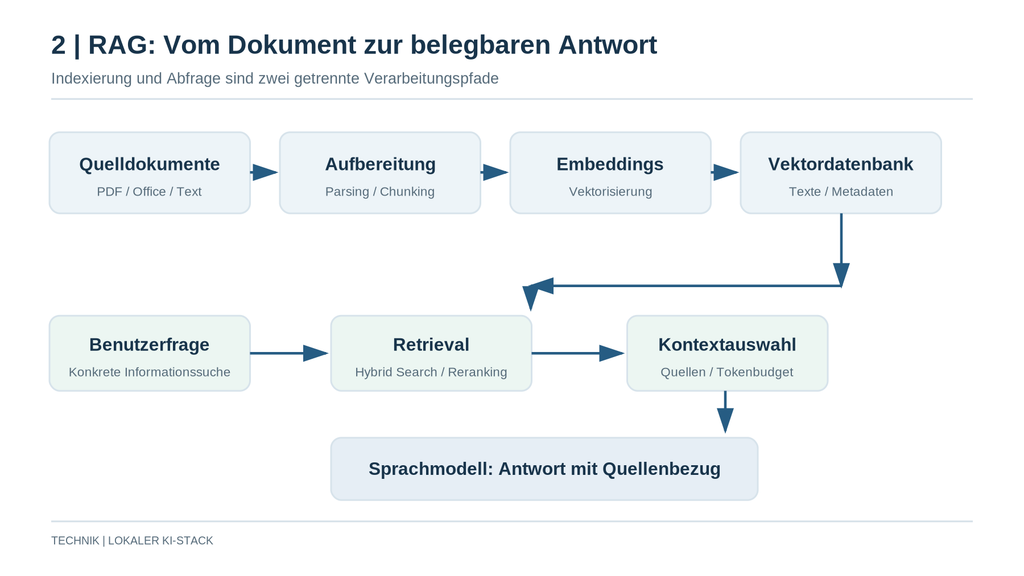
Abbildung 2: Dokumentverarbeitung und Retrieval
Ein RAG-System besteht aus zwei getrennten Vorgängen: Dokumente werden vorbereitet und indexiert; bei einer Anfrage werden passende Inhalte gesucht und dem Sprachmodell übergeben.
Die Qualität hängt allerdings nicht allein von der Vektorsuche ab. Bei vielen technischen Dokumenten ist eine Kombination aus semantischer Suche und klassischer Volltextsuche sinnvoll. Eine Versionsnummer, Fehlermeldung oder Artikelnummer lässt sich häufig über exakte Suchbegriffe besser finden als über semantische Ähnlichkeit. Solche Verfahren werden als Hybrid Search bezeichnet. Ein zusätzlicher Reranker kann die gefundenen Ergebnisse nochmals bewerten und sortieren, bevor sie an das Sprachmodell übergeben werden.
Damit stellt RAG weniger ein einzelnes Produkt als eine Verarbeitungskette dar. Jeder Schritt kann die Ergebnisqualität verbessern oder verschlechtern. Für einen produktiven Einsatz müssen deshalb nicht nur die Antworten des Sprachmodells, sondern auch Dokumentimport, Suchergebnisse und Quellenzuordnung geprüft werden. Besonders hilfreich sind Testfragen, bei denen bekannt ist, in welchem Dokument die gesuchte Information steht und ob das System tatsächlich die richtige Passage findet.
8. Der Vector Store: Chroma, Qdrant oder PostgreSQL?
Für die Speicherung der Embeddings stehen verschiedene Systeme zur Verfügung. Chroma eignet sich beispielsweise für lokale Installationen und kleinere Wissensbestände. Es kann eingebettet oder als separater Dienst betrieben werden. Qdrant bietet ebenfalls eine spezialisierte Vektordatenbank mit Serverbetrieb und zusätzlichen Suchfunktionen. Eine weitere Möglichkeit ist PostgreSQL mit der Erweiterung pgvector, wodurch sich Vektorsuche in eine ohnehin vorhandene relationale Datenbank integrieren lässt.
Die Auswahl sollte nicht nach allgemeinen Geschwindigkeitsvergleichen erfolgen. Entscheidend sind Datenmenge, gleichzeitige Zugriffe, Filtermöglichkeiten, Backup-Verfahren und die Frage, wie Benutzerrechte umgesetzt werden. Bei einem einzelnen Arbeitsplatz ist eine lokal persistente Datenbank häufig völlig ausreichend. Für mehrere gleichzeitige Benutzer oder Worker ist dagegen ein zentraler Datenbankdienst meistens die bessere Lösung, insbesondere wenn verschiedene Anwendungen auf dieselben Wissensbestände zugreifen müssen.
Ein weiterer Punkt wird bei der Planung leicht übersehen: Embeddings sind an das verwendete Modell gebunden. Wird das Embedding-Modell gewechselt, müssen vorhandene Dokumente in der Regel neu indexiert werden, weil die Vektorräume nicht beliebig kompatibel sind. Auch Änderungen beim Chunking oder bei der Textextraktion können eine erneute Verarbeitung erforderlich machen. Deshalb sollte ein produktives RAG-System festhalten, mit welchem Embedding-Modell und welcher Verarbeitungskonfiguration seine Dokumente indexiert wurden.
Bei größeren Wissensbeständen wird außerdem die Aktualisierung interessant. Dokumente werden ergänzt, überarbeitet oder gelöscht. Das Retrieval muss sicherstellen, dass veraltete Versionen nicht weiterhin als aktuelle Quelle erscheinen. Eine zuverlässige Dokumentenverwaltung benötigt deshalb eindeutige Identifikatoren, Versionsinformationen und Verfahren, mit denen bestehende Einträge gezielt aktualisiert oder entfernt werden können.
9. Kontext, RAG und Memory
Im Zusammenhang mit Sprachmodellen werden mehrere unterschiedliche Funktionen häufig unter dem Begriff Gedächtnis zusammengefasst. Tatsächlich erfüllen Gesprächskontext, RAG und persistentes Memory verschiedene Aufgaben und sollten auch architektonisch getrennt betrachtet werden. Werden diese Verfahren miteinander vermischt, entstehen sowohl technische Probleme als auch unnötige Risiken bei der Speicherung personenbezogener oder vertraulicher Informationen.
Der Gesprächskontext enthält die Informationen, die dem Modell innerhalb einer aktuellen Anfrage zur Verfügung stehen. Dazu gehören vorherige Nachrichten, Systemanweisungen, Werkzeugergebnisse und gegebenenfalls Dokumentauszüge. Dieser Kontext ist begrenzt. Auch wenn moderne Modelle große Kontextfenster unterstützen, bleibt die Verarbeitung umfangreicher Gesprächshistorien aufwendig. Mit wachsender Länge steigen Speicherbedarf und Rechenaufwand, während die Qualität der Informationsnutzung nicht zwangsläufig im gleichen Maße zunimmt.
RAG arbeitet anders. Hier werden relevante Informationen aus einem externen Datenbestand gesucht und nur die benötigten Ausschnitte in den Kontext eingefügt. Das Modell erhält dadurch Zugriff auf Informationen, die nicht dauerhaft im Gespräch enthalten sein müssen. Persistent Memory wiederum dient dazu, bestimmte Informationen über einzelne Gespräche hinaus zu erhalten. Das können Arbeitspräferenzen, wiederkehrende Einstellungen oder bestätigte Fakten sein, die bei späteren Anfragen erneut berücksichtigt werden sollen.
Die drei Verfahren sollten nicht gegeneinander ausgetauscht werden. Eine technische Dokumentation gehört in einen durchsuchbaren Wissensbestand. Eine aktuelle Aufgabenbeschreibung gehört in den Gesprächskontext. Eine dauerhaft geltende Einstellung kann im persistenten Memory gespeichert werden. Gerade bei mehreren Benutzern ist außerdem zu klären, welche Informationen persönlich und welche unternehmensweit verfügbar sein dürfen. Ein gemeinsamer Wissensbestand bedeutet nicht automatisch ein gemeinsames Benutzer-Memory.
10. Webrecherche mit einem lokalen Modell
Ein lokal ausgeführtes Sprachmodell kennt keine aktuellen Ereignisse, sofern ihm diese Informationen nicht über eine externe Quelle bereitgestellt werden. Die naheliegende Lösung ist die Anbindung einer Suchmaschine. SearXNG lässt sich selbst betreiben und über eine API abfragen. Eine Anwendung kann damit Suchanfragen ausführen, die Ergebnisse aufbereiten und dem Sprachmodell übergeben. Auf diese Weise wird die lokale Modellinferenz um aktuelle Informationen ergänzt, ohne dass die eigentliche Textgenerierung zu einem externen Anbieter ausgelagert werden muss.
Die Inferenz bleibt dabei lokal. Die Suchanfrage selbst verlässt jedoch gegebenenfalls das Unternehmensnetz, ebenso wie der Abruf externer Webseiten. Dieser Unterschied ist wichtig, weil ein System mit lokaler Modellinferenz nicht automatisch vollständig offline arbeitet. Für Unternehmen bietet sich deshalb eine klare Trennung zwischen internen Wissensbeständen und externen Recherchequellen an. Interne Dokumente müssen nicht über eine Suchmaschine laufen, und externe Webseiten sollten nicht ungeprüft in den dauerhaften Wissensbestand übernommen werden.
Bei der Webrecherche entstehen zudem Sicherheitsrisiken. Webseiten können Inhalte enthalten, die versuchen, das Sprachmodell zu bestimmten Aktionen zu veranlassen. Solche Prompt-Injection-Angriffe sind besonders dann problematisch, wenn das Modell gleichzeitig Zugriff auf Dateien oder Systemwerkzeuge besitzt. Externe Inhalte sollten deshalb grundsätzlich als Daten und nicht als vertrauenswürdige Anweisungen behandelt werden. Die Steuerung muss verhindern, dass Inhalte aus einer Webseite unmittelbar Berechtigungen oder Arbeitsaufträge verändern können.
Auch die Qualität der Suchergebnisse darf nicht überschätzt werden. Eine Suchmaschine liefert zunächst Fundstellen und Auszüge, deren Aktualität und Zuverlässigkeit unterschiedlich sein können. Für fachlich anspruchsvolle Aufgaben ist es deshalb sinnvoll, relevante Quellen tatsächlich abzurufen und auszuwerten, statt ausschließlich die kurzen Suchergebnisbeschreibungen an das Modell weiterzugeben.
11. Bildgenerierung: Modelle über Workflows ausführen
Während Sprachmodelle überwiegend sequenziell Token erzeugen, arbeiten Bildgeneratoren mit anderen Modellarchitekturen und Ausführungsverfahren. ComfyUI hat sich als flexible Umgebung für solche Aufgaben etabliert. Die Anwendung organisiert die Verarbeitung als Graphen aus einzelnen Knoten, die Modelle laden, Eingaben verarbeiten, Sampling-Schritte ausführen und Ergebnisse speichern. Dadurch lassen sich auch komplexere Bildverarbeitungen nachvollziehbar beschreiben und wiederholen.
Ein solcher Workflow kann über eine Benutzeroberfläche erstellt und anschließend über eine API ausgeführt werden. Damit eignet sich ComfyUI als Backend für einen lokalen KI-Stack, ohne dass die eigentliche Bildgenerierung unmittelbar in der Chatoberfläche stattfinden muss. Ein Sprachmodell kann beispielsweise aus einer Benutzeranweisung einen strukturierten Bildauftrag erzeugen. Dieser wird einem vorbereiteten Workflow übergeben, ComfyUI führt die Generierung aus und stellt die Bilddatei anschließend bereit. Die Trennung ermöglicht es, denselben Workflow auch aus anderen Anwendungen heraus zu verwenden.
Modelle wie Z-Image oder Chroma zeigen, dass lokal ausgeführte Bildgenerierung inzwischen weit über einfache Demonstrationen hinausgeht. Die genauen Hardwareanforderungen hängen allerdings stark vom Modell, der Auflösung, der Präzision und dem verwendeten Workflow ab. Auch zusätzliche Verfahren wie LoRAs, Upscaling oder bildbasierte Bearbeitungsschritte können den Speicherbedarf erheblich verändern. Deshalb sollte nicht nur das Basismodell, sondern immer der vollständige Workflow getestet werden.
Für Unternehmen ist weniger die Zahl verfügbarer Modelle entscheidend als die Reproduzierbarkeit. Ein definierter Workflow sollte festhalten, welche Modellversion, welche LoRAs und welche Parameter verwendet wurden. Das ermöglicht es, Bildgenerierung gezielt in bestehende Abläufe einzubinden. Bei Werbeagenturen können beispielsweise wiederkehrende Bildformate, bestimmte Auflösungen oder festgelegte Bearbeitungsschritte sinnvoll sein. Die eigentliche Modellwahl bleibt dabei austauschbar, sofern sich die Anforderungen des Workflows weiterhin erfüllen lassen.
12. Videogenerierung: deutlich höhere Anforderungen
Die lokale Videogenerierung stellt wesentlich höhere Anforderungen als die Erzeugung einzelner Bilder. Ein Videomodell verarbeitet zeitliche Zusammenhänge zwischen aufeinanderfolgenden Frames. Hinzu kommen größere Datenmengen und häufig komplexere Verfahren zur Speicheroptimierung. Die Anforderungen steigen zusätzlich mit Auflösung, Bildrate und Videolänge, weshalb sich Ergebnisse aus kurzen Testsequenzen nur eingeschränkt auf längere Produktionen übertragen lassen.
Wan 2.2 ist ein Beispiel für diese Entwicklung. Das Modell kann für Text-zu-Video- und andere videobezogene Aufgaben verwendet werden, benötigt je nach Ausführungsvariante aber erhebliche Ressourcen. Optimierte Modellformate, FP8 und Offloading ermöglichen die Ausführung auf kleinerer Hardware. Dabei wird ein Teil der Daten gegebenenfalls in den Hauptspeicher verschoben oder das Modell in geeigneten Abschnitten verarbeitet. Das spart VRAM, kann aber die Ausführung erheblich verlangsamen.
Für einen kleinen KI-Server folgt daraus eine praktische Konsequenz: Videogenerierung sollte als geplanter Hintergrundauftrag behandelt werden. Ein Benutzer startet einen Auftrag, die Steuerung legt ihn in einer Warteschlange ab und die GPU führt ihn aus, sobald ausreichend Ressourcen verfügbar sind. Die Anwendung muss dabei zwischen angenommenen, laufenden, abgeschlossenen und fehlgeschlagenen Aufträgen unterscheiden. Ein längerer Videojob darf nicht dazu führen, dass die gesamte Bedienoberfläche blockiert oder andere Dienste unkontrolliert beendet werden.
Zusätzlich müssen Ergebnisse und Zwischendateien verwaltet werden. Videodateien benötigen deutlich mehr Speicherplatz als gewöhnliche Textantworten oder einzelne Bilder. Bei wiederholten Generierungsversuchen können schnell größere Datenmengen entstehen. Eine produktive Installation benötigt deshalb Regeln für die Ablage, Aufbewahrung und Bereinigung dieser Dateien, insbesondere wenn mehrere Benutzer denselben Speicher verwenden.
13. Ein Rechner, ein GPU-Speicher
Die eigentliche Schwierigkeit bei der Kombination mehrerer KI-Funktionen besteht im gemeinsamen Ressourcenverbrauch. Ein Sprachmodell kann bereits einen großen Teil des Grafikspeichers belegen. Ein Bildgenerator benötigt wiederum eigene Modellgewichte und Arbeitsbereiche. Wird anschließend ein Videomodell gestartet, reicht der verbliebene Speicher möglicherweise nicht aus. Ohne koordinierte Ressourcenverwaltung reagieren die Anwendungen darauf häufig mit Ladefehlern oder Speicherüberschreitungen.
Ein verbreiteter Ansatz besteht deshalb darin, Modelle nur bei Bedarf zu laden. Das Sprachmodell kann für interaktive Aufgaben im Speicher bleiben, während Bild- und Videomodelle geladen werden, sobald entsprechende Aufträge vorliegen. Nach Abschluss können sie wieder entladen werden. Dieses Verfahren hat allerdings einen Nachteil: Modellwechsel kosten Zeit. Die Ladezeit hängt von Größe, Datenträgerleistung, Arbeitsspeicher und Runtime ab. Bei großen Modellen sind Verzögerungen deutlich spürbar.
Es ist deshalb sinnvoll, Aufgaben nach Art und Priorität zu unterscheiden. Interaktive Chat-Anfragen benötigen möglichst kurze Reaktionszeiten, während umfangreiche Bild- oder Videoaufträge häufig warten können. Eine einfache Ressourcensteuerung kann dafür sorgen, dass bestimmte Modellklassen nicht gleichzeitig ausgeführt werden oder dass Hintergrundaufträge erst beginnen, wenn die GPU ausreichend freien Speicher besitzt.
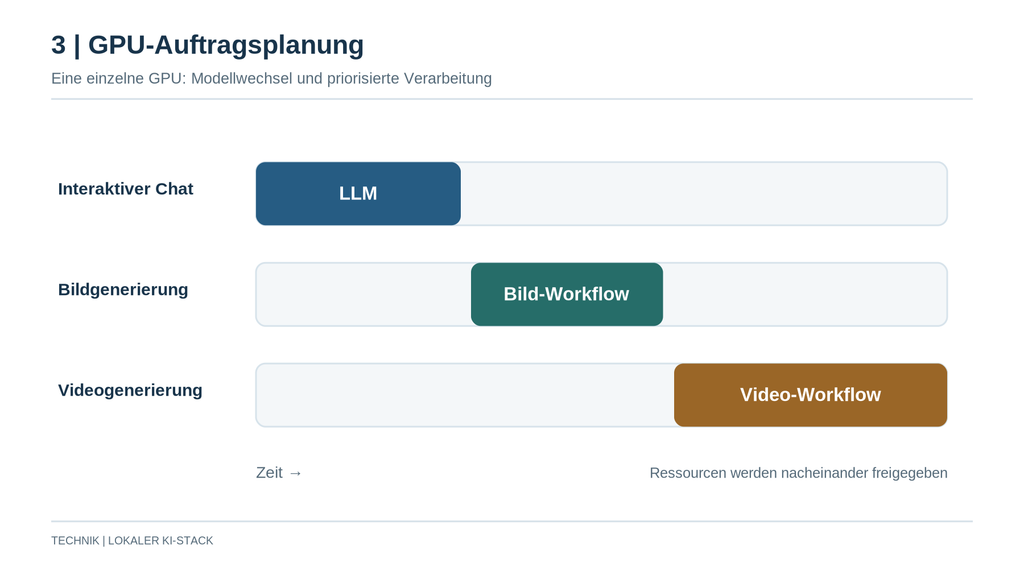
Abbildung 3: Beispiel einer GPU-Auftragsplanung
Vereinfachtes Beispiel für die zeitliche Zuordnung verschiedener Modellklassen. Der tatsächliche Ablauf muss Ladezeiten, Prioritäten und verbleibenden Speicher berücksichtigen.
Die Ressourcensteuerung muss nicht von Anfang an besonders aufwendig sein. Für einen kleinen Firmenserver genügt häufig eine einfache Queue mit klaren Prioritäten. Wichtig ist vor allem, dass nicht mehrere voneinander unabhängige Anwendungen gleichzeitig versuchen, denselben Grafikspeicher vollständig zu belegen. Erst bei höherer Last wird eine differenziertere Planung interessant, die beispielsweise den Speicherbedarf einzelner Aufträge berücksichtigt oder mehrere GPUs gezielt verschiedenen Aufgaben zuordnet.
14. MCP: wenn Sprachmodelle Werkzeuge benutzen
Bislang wurden Sprachmodelle überwiegend als Systeme betrachtet, die Informationen verarbeiten und Antworten erzeugen. Mit Tool Calling können sie darüber hinaus externe Funktionen verwenden. Eine Anwendung stellt dem Modell eine Beschreibung verfügbarer Werkzeuge zur Verfügung. Das Modell kann daraufhin entscheiden, eine passende Funktion aufzurufen und entsprechende Parameter zu erzeugen. Die tatsächliche Ausführung übernimmt jedoch nicht das Modell selbst, sondern eine Anwendung beziehungsweise Werkzeugruntime.
Das Model Context Protocol, kurz MCP, standardisiert Teile dieser Kommunikation. Es unterscheidet unter anderem Tools, Resources und Prompts. Über MCP können unterschiedliche Anwendungen auf dieselben bereitgestellten Fähigkeiten zugreifen, sofern sie das Protokoll unterstützen. Ein lokaler KI-Stack kann darüber beispielsweise Funktionen für Dateisystemzugriffe, Datenbankabfragen, PowerShell-Skripte oder externe Anwendungen bereitstellen. Dabei muss die eigentliche Fachlogik nicht in der Chatoberfläche implementiert werden, sondern kann als separater Dienst bestehen bleiben.
Das bedeutet allerdings nicht, dass ein Modell automatisch sämtliche Fähigkeiten des Rechners erhalten sollte. Zwischen lesenden Funktionen und verändernden Eingriffen besteht ein erheblicher Unterschied. Eine Datei aufzulisten ist weniger kritisch als sie zu löschen. Eine Systemkonfiguration auszulesen ist etwas anderes, als einen Dienst zu stoppen oder Firewallregeln zu verändern. Die Werkzeugschicht muss deshalb Berechtigungen und Einschränkungen durchsetzen, die unabhängig von den Anweisungen des Modells gelten.
Für den Betrieb ist außerdem wichtig, dass Werkzeugaufrufe nachvollziehbar bleiben. Ein Agent sollte nicht nur das Ergebnis einer Aktion erhalten, sondern gegebenenfalls auch strukturierte Informationen über Ausführung, Fehler und überprüfte Zustandsänderungen. Dadurch lässt sich später nachvollziehen, warum ein bestimmter Arbeitsschritt erfolgreich war oder weshalb er abgebrochen wurde.
15. Agenten: mehrere Werkzeugaufrufe hintereinander
Die Kombination aus Sprachmodell und Werkzeugen ermöglicht die Entwicklung lokaler Agenten. Im einfachsten Fall besteht ein solcher Agent aus einer wiederholten Folge von Modellanfrage, Werkzeugaufruf und Ergebnisprüfung. Ein Benutzer könnte beispielsweise verlangen, eine Sammlung technischer Dokumente zu untersuchen und daraus eine strukturierte Übersicht zu erstellen. Der Agent sucht zunächst passende Dokumente, liest relevante Abschnitte und prüft gegebenenfalls weitere Quellen. Anschließend erzeugt er das gewünschte Ergebnis.
Komplexere Aufgaben können zusätzliche Schritte enthalten. Beispielsweise muss ein Skript ausgeführt, dessen Ergebnis interpretiert und bei einem Fehler eine Korrektur vorgenommen werden. Die Steuerung übergibt dem Modell nach jedem Werkzeugaufruf die relevanten Ergebnisse und lässt es entscheiden, ob weitere Aktionen erforderlich sind. Dadurch entsteht ein Agent-Loop, der sich aus mehreren aufeinanderfolgenden Entscheidungen zusammensetzt.
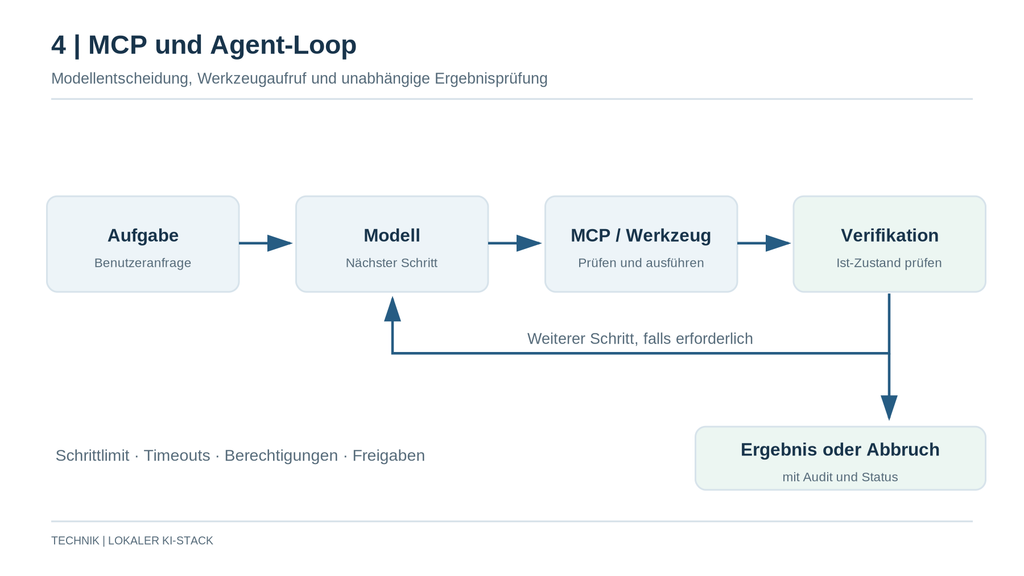
Abbildung 4: Vereinfachter Agent-Loop
Ein Agent sollte nicht unbegrenzt weiterarbeiten. Die Steuerung muss Ausführungsschritte zählen, Werkzeugaufrufe prüfen und definieren, wann eine Aufgabe erfolgreich oder fehlgeschlagen ist.
Damit unterscheidet sich ein Agent wesentlich von einem einfachen Chat. Bei jedem zusätzlichen Schritt können Fehler entstehen. Ein unpassendes Suchergebnis führt möglicherweise zum falschen Dokument. Ein fehlerhafter Werkzeugaufruf verändert Daten oder liefert ein unvollständiges Ergebnis. Deshalb benötigt die Orchestrierung klare Grenzen. Dazu gehören maximale Schrittzahlen, Zeitlimits, überprüfbare Werkzeugergebnisse und eine nachvollziehbare Fehlerbehandlung.
Besonders wichtig ist die Erfolgskontrolle. Ein Kommando, das mit Exitcode null beendet wurde, hat nicht zwangsläufig die gewünschte Wirkung erzielt. Ein Dienstneustart sollte beispielsweise anschließend durch eine Zustandsabfrage geprüft werden. Bei Änderungen an Dateien kann ein erneutes Einlesen oder ein Vergleich des Inhalts erforderlich sein. Für sicherheitsrelevante Änderungen sind zusätzliche Freigaben und Schutzmechanismen notwendig.
Der tatsächliche Nutzen solcher Agenten ergibt sich nicht daraus, möglichst viele Aktionen ohne Benutzereingriff auszuführen. Interessant ist vielmehr, klar definierte Arbeitsabläufe durchzuführen und deren Ergebnisse zuverlässig überprüfen zu können. Ein Agent, der eine Aufgabe nach wenigen Schritten kontrolliert abbricht und eine nachvollziehbare Fehlermeldung liefert, ist für den produktiven Betrieb häufig wertvoller als ein System, das unbegrenzt weitere Aktionen versucht.
16. Sicherheit: lokale Inferenz ist nur ein Teil der Lösung
Bei lokal betriebenen Sprachmodellen verlassen die an die Runtime übergebenen Daten nicht zwangsläufig das eigene System. Daraus wird gelegentlich abgeleitet, lokale KI sei grundsätzlich sicherer als ein externer Dienst. So einfach ist die Situation nicht. Sobald eine zentrale Anwendung von mehreren Benutzern verwendet wird, entstehen klassische Anforderungen an Authentifizierung, Autorisierung und Datenisolation. Die eigentliche Modellinferenz mag vollständig lokal erfolgen, während andere Komponenten dennoch Verbindungen nach außen aufbauen oder auf vertrauliche Unternehmensdaten zugreifen.
Dokumente müssen dem richtigen Benutzer beziehungsweise Projekt zugeordnet sein. API-Schlüssel dürfen nicht ungeschützt in Konfigurationsdateien oder Protokollen liegen. Administrative Funktionen dürfen nicht für normale Benutzer erreichbar sein. Besonders kritisch ist der Werkzeugzugriff, weil hier aus einer zunächst rein informativen Anwendung ein System wird, das tatsächliche Veränderungen durchführen kann.
Ein Modell, das ausschließlich Texte erzeugt, kann falsche Informationen liefern. Ein Modell mit Shell-Zugriff kann zusätzlich Dateien verändern, Anwendungen starten oder Netzwerkanfragen ausführen. Die Berechtigungen müssen deshalb in der Ausführungsumgebung begrenzt werden. Eine bloße Systemanweisung wie „Verändere keine wichtigen Dateien“ ist keine Sicherheitsmaßnahme. Auch MCP löst dieses Problem nicht automatisch. Das Protokoll standardisiert die Kommunikation, ersetzt aber keine Rechteverwaltung oder Systemisolation.
Für einen kleinen Firmenserver sind deshalb vergleichsweise klassische Maßnahmen sinnvoll. Dienste sollten nur auf erforderlichen Interfaces bereitgestellt, Benutzerrechte beschränkt, Verbindungen abgesichert und Secrets getrennt verwaltet werden. Sicherheitsrelevante Aktionen müssen protokolliert werden, damit sich Änderungen im Nachhinein nachvollziehen lassen. Bei Werkzeugen, die Dateien verändern oder administrative Funktionen ausführen, sollten zusätzlich die betroffenen Ziele und die zulässigen Operationen technisch begrenzt werden.
Eine weitere Herausforderung ergibt sich durch externe Inhalte. RAG-Dokumente und Webseiten können manipulative Anweisungen enthalten. Werden diese ungeprüft als vertrauenswürdiger Kontext verarbeitet, kann ein Modell dazu gebracht werden, seine eigentliche Aufgabe zu verlassen. Die Architektur sollte deshalb zwischen Benutzeranweisungen, Systemvorgaben und externen Daten unterscheiden. Hochriskante Werkzeuge benötigen zusätzliche technische Prüfungen, unabhängig davon, welche Entscheidung das Modell vorgeschlagen hat.
17. Installation und Betrieb: der unterschätzte Teil
Die Installation eines lokalen Sprachmodells ist heute selten das eigentliche Problem. Schwieriger wird es, wenn ein vollständiger Stack dauerhaft betrieben werden soll. Mehrere Komponenten verwenden unterschiedliche Python-Versionen, CUDA-Abhängigkeiten, Datenbanken und Startmechanismen. Ein Update kann eine Schnittstelle verändern oder bisher funktionierende Workflows beeinträchtigen. Wer sämtliche Anwendungen manuell installiert und konfiguriert, erhält damit häufig einen funktionierenden Rechner, dessen Zustand sich aber nur schwer reproduzieren lässt.
Für einen produktiven Einsatz sollte bereits die Installation nachvollziehbar sein. Dazu gehören definierte Versionen, dokumentierte Abhängigkeiten und ein Verfahren, mit dem die Konfiguration auf einem neuen Rechner wiederhergestellt werden kann. Ein Installer muss dabei nicht zwangsläufig alle Modellgewichte enthalten. Gerade große Modelle können separat bezogen und anhand von Prüfsummen verifiziert werden. Wichtiger ist, dass der gewünschte Systemzustand eindeutig beschrieben ist und die Installation bei wiederholter Ausführung keine unkontrollierten Änderungen verursacht.
Nach der Installation müssen die Komponenten nicht nur gestartet, sondern auch geprüft werden. Ein erreichbarer HTTP-Port sagt noch nichts darüber aus, ob ein Sprachmodell tatsächlich geladen werden kann. Ebenso bedeutet eine gestartete ComfyUI-Instanz nicht, dass ein definierter Videoworkflow erfolgreich ausgeführt wird. Ein brauchbarer Health Check muss deshalb unterschiedliche Ebenen berücksichtigen: Prozesszustand, API-Erreichbarkeit, Modellverfügbarkeit und gegebenenfalls eine tatsächliche Testausführung.
Ähnlich verhält es sich mit Backups. Modellgewichte sind häufig erneut beschaffbar. Benutzerkonten, Chats, Konfigurationen, eigene Workflows und Wissensdatenbanken müssen dagegen gesichert werden. Eine Datensicherung ist außerdem erst dann belastbar, wenn eine Wiederherstellung getestet wurde. Besonders bei Datenbanken reicht es nicht, während des laufenden Betriebs beliebige Dateien zu kopieren. Es müssen die jeweils vorgesehenen konsistenten Backup-Verfahren verwendet werden.
Für einen lokalen KI-Stack ist deshalb ein kontrollierter Wiederherstellungsprozess mindestens ebenso wichtig wie ein komfortabler Installer. Im Fehlerfall muss klar sein, welche Daten zurückgespielt, welche Komponenten neu installiert und welche Konfigurationen anschließend geprüft werden müssen. Ohne diese Verfahren bleibt auch ein technisch leistungsfähiger KI-Stack ein System, dessen Wiederherstellung stark vom Wissen der Person abhängt, die ihn ursprünglich eingerichtet hat.
18. Vom Einzelplatz zum Firmenserver
Ein einzelner KI-Arbeitsplatz unterscheidet sich technisch erheblich von einem Server, auf dem mehrere Mitarbeiter gleichzeitig arbeiten. Am Einzelplatz ist es unproblematisch, wenn ein Modellwechsel einige Sekunden benötigt. Auch ein größerer Videoauftrag kann die GPU längere Zeit vollständig belegen. Bei mehreren Benutzern entstehen dagegen konkurrierende Anforderungen, die sich nicht mehr allein durch eine möglichst leistungsfähige Grafikkarte lösen lassen.
Während ein Mitarbeiter mit einem Sprachmodell arbeitet, startet ein anderer eine Dokumentenanalyse. Gleichzeitig läuft möglicherweise eine Bildgenerierung. Nun müssen Ressourcen verteilt und Anfragen gegebenenfalls in Warteschlangen gestellt werden. Dabei wächst nicht nur die Belastung der GPU. Auch Datenbanken, Dokumentenspeicher, Benutzerverwaltung und Hintergrundprozesse müssen mehrere gleichzeitige Zugriffe vertragen.
Für einen kleinen Firmenserver kann ein einzelner leistungsfähiger Rechner weiterhin ausreichend sein. Die Anwendungen sollten dann allerdings bereits wie Serverdienste betrieben werden. Das bedeutet nicht, dass sofort eine komplexe Containerorchestrierung erforderlich wäre. Ein einzelner Host mit sauber verwalteten Diensten, zentralem Monitoring und kontrollierten Updates ist häufig einfacher und besser beherrschbar. Erst wenn Verfügbarkeit, Benutzerzahl oder Rechenbedarf entsprechend wachsen, wird eine Verteilung auf mehrere Systeme interessant.
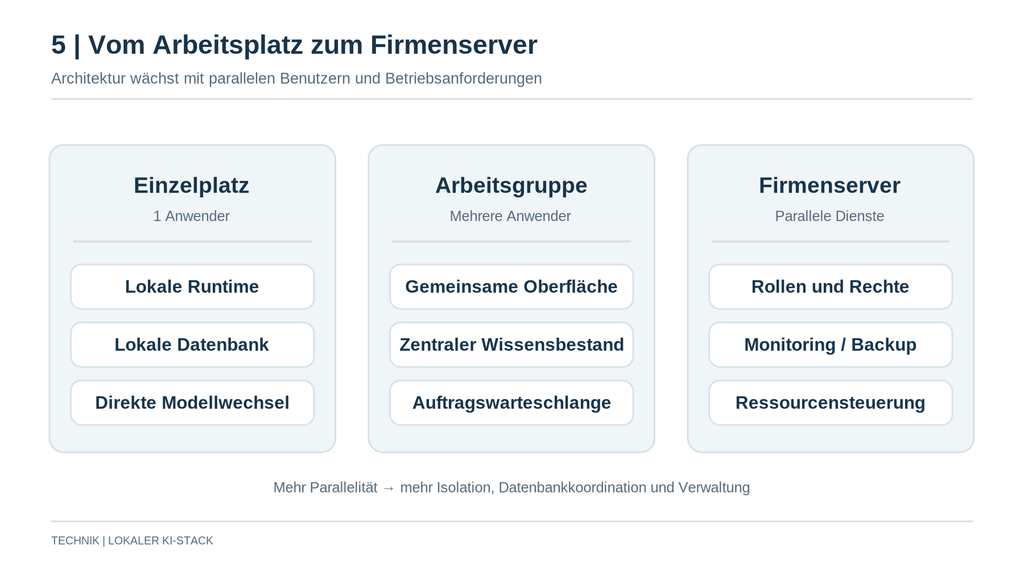
Abbildung 5: Entwicklung vom Arbeitsplatz zum Mehrbenutzersystem
Mit zunehmender Nutzung ändern sich vor allem Datenhaltung, Zugriffskontrolle und Ressourcenplanung. Die grundsätzliche Trennung von Modellen, Wissen und Werkzeugen bleibt erhalten.
Für kleinere Unternehmen ist es sinnvoll, diese Entwicklung bereits bei der Erstinstallation zu berücksichtigen. Komponenten sollten austauschbar bleiben, ohne dass von Anfang an eine große Infrastruktur aufgebaut werden muss. Eine lokale Datenbank kann später durch einen zentralen Dienst ersetzt werden, während sich die Modellruntime unabhängig davon auf andere Hardware verlagern lässt. Voraussetzung ist allerdings, dass die entsprechenden Schnittstellen von Beginn an sauber getrennt wurden.
19. Kosten und Lizenzen
Lokale KI wird häufig mit dem Argument beworben, nach Anschaffung der Hardware würden keine laufenden Kosten mehr entstehen. Das ist nur teilweise richtig. Zwar entfallen bei rein lokaler Inferenz die nutzungsabhängigen API-Gebühren eines externen Modellanbieters. Dafür entstehen Kosten für Hardware, Strom, Datensicherung, Administration und regelmäßige Aktualisierungen. Auch die Zeit, die Mitarbeiter für die Betreuung der Plattform aufwenden, muss in eine wirtschaftliche Betrachtung einbezogen werden.
Hinzu kommt die Lebensdauer der Hardware. Neue Modelle können höhere Anforderungen stellen oder Funktionen voraussetzen, die auf älteren GPUs nur eingeschränkt unterstützt werden. Eine einmal angeschaffte Grafikkarte bleibt zwar grundsätzlich nutzbar, muss aber nicht zwangsläufig auch zukünftige Modellgenerationen in der gewünschten Geschwindigkeit ausführen können. Gerade bei einer langfristigen Investition sollte deshalb nicht ausschließlich der gegenwärtige Leistungsbedarf betrachtet werden.
Bei geringer Nutzung ist ein Cloud-Dienst häufig wirtschaftlicher. Ein leistungsfähiger lokaler Rechner lohnt sich eher, wenn regelmäßig größere Datenmengen verarbeitet werden oder besondere Anforderungen an Kontrolle und Datenhaltung bestehen. Auch Mischformen sind denkbar, bei denen interne Dokumente lokal verarbeitet werden, während besonders aufwendige Aufgaben bei Bedarf über externe Dienste laufen. Eine solche Architektur setzt allerdings voraus, dass klar geregelt ist, welche Daten an welche Systeme übermittelt werden dürfen.
Zusätzlich müssen Modell- und Softwarelizenzen geprüft werden. Die Veröffentlichung von Modellgewichten bedeutet nicht zwangsläufig, dass diese ohne Einschränkungen kommerziell verwendet werden dürfen. Auch Open-Source-Lizenzen der Anwendungen und gegebenenfalls besondere Bedingungen einzelner Modelle müssen berücksichtigt werden. Für eine Firma gehört deshalb eine Dokumentation der eingesetzten Modellversionen und Lizenzbedingungen zum regulären Betrieb.
20. Erweiterbarkeit statt möglichst vieler Funktionen
Ein lokaler KI-Stack kann technisch nahezu beliebig erweitert werden. Spracherkennung, Text-to-Speech, Telefonie, CRM-Systeme, Buchhaltung, Entwicklungswerkzeuge oder branchenspezifische Fachanwendungen lassen sich über passende Schnittstellen anbinden. Daraus folgt allerdings nicht, dass sämtliche Funktionen bereits in einer Grundinstallation vorhanden sein sollten. Jede zusätzliche Komponente erzeugt Abhängigkeiten, benötigt Wartung und erweitert die Angriffsfläche.
Für kleinere Unternehmen ist deshalb ein überschaubarer Grundstack sinnvoller, der Sprachmodelle, Wissensverarbeitung, Webrecherche, Bild- und Videogenerierung sowie einen kontrollierten Werkzeugzugriff bereitstellt. Die weitere Entwicklung kann dann anhand tatsächlicher Anforderungen erfolgen. Benötigt eine Agentur beispielsweise eine automatische Bildverarbeitung, lässt sich ein entsprechender Workflow ergänzen. Soll ein technisches Unternehmen Dokumentationen auswerten und Berichte erstellen, kann es zusätzliche RAG- und Agentenfunktionen entwickeln.
Entscheidend ist, dass solche Erweiterungen über definierte APIs oder MCP eingebunden werden und keine tiefgreifenden Veränderungen am Kernsystem erfordern. Auf diese Weise bleibt die Plattform beherrschbar. Der Grundstack liefert die technische Infrastruktur, während die eigentlichen Fachanwendungen erst dort entstehen, wo sie benötigt werden. Die vorhandenen Komponenten können damit auch als Ausgangspunkt für eigene Entwicklungen dienen, ohne dass das Unternehmen zunächst eine vollständige KI-Plattform selbst programmieren muss.
21. Fazit
Die technischen Voraussetzungen für lokale KI haben sich in den vergangenen Jahren erheblich verbessert. Sprachmodelle mit mehreren Milliarden Parametern lassen sich auf leistungsfähiger Standardhardware ausführen. Bildgenerierung ist auf Consumer-GPUs längst praktikabel, und selbst Videomodelle können mit geeigneten Optimierungen lokal betrieben werden. Auch die notwendigen Softwarekomponenten sind verfügbar. Modellruntimes, Benutzeroberflächen, Vektordatenbanken, Suchmaschinen und Workflow-Systeme müssen nicht mehr selbst entwickelt werden.
Die Schwierigkeit liegt inzwischen vor allem in ihrer Kombination. Ein einzelner Rechner kann durchaus Sprachmodelle, RAG, Webrecherche sowie Bild- und Videogenerierung bereitstellen. Voraussetzung ist allerdings eine Architektur, die die unterschiedlichen Ressourcenanforderungen berücksichtigt und die einzelnen Komponenten sauber voneinander trennt. Modelle müssen austauschbar bleiben, Datenbestände unabhängig von der jeweiligen Oberfläche verwaltet werden können und Hintergrundaufträge dürfen den interaktiven Betrieb nicht unkontrolliert beeinträchtigen.
Besonders wichtig wird diese Trennung beim Übergang von der reinen Textgenerierung zu Agenten und Werkzeugen. Sobald ein Modell nicht mehr nur Antworten liefert, sondern auf Dateien, Anwendungen oder Betriebssystemfunktionen zugreifen kann, sind kontrollierte Berechtigungen und überprüfbare Ausführungsergebnisse erforderlich. Die Qualität eines solchen Systems bemisst sich daher nicht allein an den Fähigkeiten des verwendeten Sprachmodells, sondern ebenso an der Zuverlässigkeit seiner Schnittstellen und der Nachvollziehbarkeit seiner Aktionen.
Für kleinere Unternehmen dürfte deshalb nicht die möglichst große Zahl installierter Modelle entscheidend sein. Interessanter ist ein überschaubarer Grundstack, dessen Zustand sich reproduzieren, aktualisieren und im Fehlerfall wiederherstellen lässt. Eine solche Plattform stellt lokale Rechenleistung, Wissensbestände und Werkzeuge über definierte Schnittstellen bereit und ermöglicht es dem Unternehmen, darauf aufbauend eigene Anwendungen zu entwickeln. Damit ist lokale KI weniger eine Frage einzelner Programme als eine klassische Architektur- und Betriebsaufgabe geworden.
Weiterführende Projekte und Dokumentation
Für die technische Vertiefung eignen sich insbesondere die Projekte llama.cpp und Ollama zur lokalen Modellinferenz, vLLM für höhere parallele Lasten sowie Open WebUI als Beispiel einer zentralen Bedienoberfläche. Für Bild- und Videoworkflows ist ComfyUI relevant, während Chroma und Qdrant verschiedene Ansätze zur Vektorspeicherung zeigen. SearXNG stellt eine selbst betreibbare Metasuche bereit; die Spezifikation des Model Context Protocol beschreibt die standardisierte Anbindung externer Werkzeuge und Ressourcen.
Projekt und Quellcode
https://github.com/robertbackhaus-a11y/KI-Stack
Dort befinden sich der vollständige Sourcecode, der Complete Installer, Installations- und Betriebsanleitungen, technische Dokumentation, Release-Unterlagen sowie die Validierungs- und Recovery-Werkzeuge. Die eigentlichen Modellgewichte werden bewusst nicht in Git eingecheckt. Der Installer lädt sie anhand definierter Quellen und Integritätsverträge oder übernimmt bereits vorhandene beziehungsweise vorbereitete lokale Modelle. Weitere Beiträge und Aktualisierungen zum Projekt finden sich auf okami.de in der Kategorie: