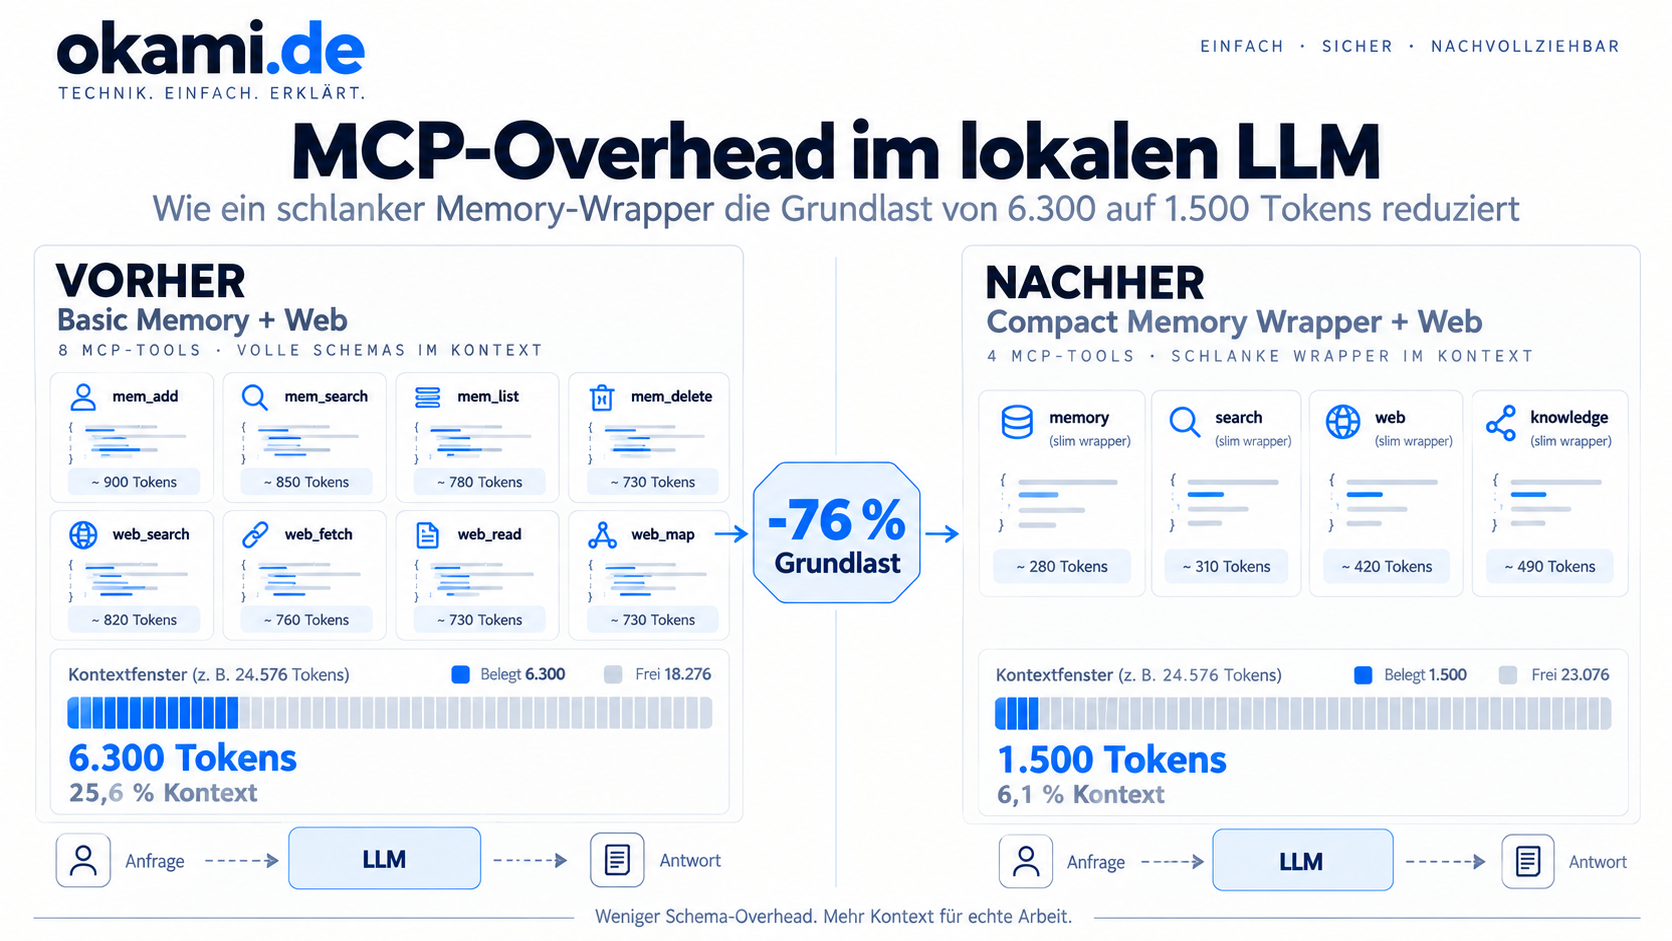
MCP-Werkzeuge machen lokale LLMs mächtig – können aber überraschend viel Kontext kosten. In einem Jan-Setup belegten Basic-Memory-Tools bereits vor der ersten eigentlichen Antwort mehr als 5.000 Tokens. Eine kontrollierte Messung führte schließlich zu einem schlanken MCP-Wrapper, der den gesamten Start-Overhead von rund 6.300 auf etwa 1.500 Tokens reduzierte.
Der konkrete Auslöser war hier Basic Memory, das zugrunde liegende Problem ist aber allgemeiner: Jeder MCP-Server und jedes Tool-Schema kostet Kontext. Je mehr Werkzeuge ein Modell gleichzeitig kennt und je ausführlicher deren Parameterbeschreibungen ausfallen, desto größer wird dieser statische Sockel. Die hier beschriebene Mess- und Optimierungsmethode lässt sich deshalb auf praktisch jedes MCP-basierte Tooling übertragen – von Dateizugriff und Datenbanken über Webrecherche bis zu Fachtools und Agenten-Workflows.
Kurz zu Jan
Jan ist eine kostenlose, quelloffene Desktop-Anwendung unter Apache 2.0 für lokale LLM-Workflows unter Windows, macOS und Linux. Jan kann GGUF-Modelle über eine integrierte llama.cpp-Runtime selbst ausführen, lässt sich aber ebenso mit externen OpenAI-kompatiblen Model-Providern betreiben.
Im hier beschriebenen Zielaufbau übernimmt Jan die Rolle von Oberfläche, Projekt- und Tool-Orchestrierung. Die eigentliche Modellinferenz läuft auf einer separaten, lokal betriebenen Ollama-Serverinstanz. Jan spricht diese über die OpenAI-kompatible API an. Dadurch bleiben Modellbetrieb und Benutzeroberfläche sauber voneinander getrennt.
Für den Artikel relevante Komponenten sind damit vor allem Projects, die MCP-Anbindung, die integrierte Websuche, der kompakte Memory-Wrapper sowie die externe Ollama-Runtime für die eigentliche Inferenz.
Der Befund: Ein Viertel des Kontextfensters war weg, bevor die Arbeit begann
Ausgangspunkt waren auffällig hohe Tokenverbräuche in mehreren Jan-Projekten. Dazu gehörte unter anderem „18Bravo“, ein lokal laufender Assistent für Waffenkunde und Ballistik. Neben Websuche und Fachwerkzeugen war Basic Memory als persistentes Gedächtnis angebunden.
Die kontrollierte Messreihe wurde anschließend im Projekt „IT-Technik“ durchgeführt. Zu diesem Zeitpunkt lief das Modell noch über Jans integrierte llama.cpp-Runtime.
Ein neuer Chat benötigte bereits bei einer minimalen Anfrage rund 6.300 Input-Tokens, obwohl noch kein Werkzeug tatsächlich benutzt worden war.
Bei dem damals effektiv nutzbaren Kontext von 24.576 Tokens waren damit schon 25,6 Prozent des Fensters verbraucht, bevor die eigentliche fachliche Arbeit begonnen hatte.
Die spätere Umstellung auf eine eigene Ollama-Serverinstanz ändert an der Ursache dieses MCP-Schema-Overheads nichts. Sie beseitigt jedoch die zusätzliche Jan-spezifische Einschränkung durch dessen interne llama.cpp-Slot-Verwaltung.
Die üblichen Verdächtigen waren es nicht
Zunächst lag der Verdacht auf einer zu großen Zahl aktiver MCP-Werkzeuge. Das ließ sich schnell ausschließen: Basic Memory war bereits von seinem vollständigen Funktionsumfang auf acht für den Anwendungsfall relevante Tools reduziert worden.
Auch das sichtbare Reasoning des verwendeten Modells erwies sich als falsche Spur. Das Modell gab Teile seines Denkprozesses als normalen Text aus. Ein llama.cpp-Flag zur Unterdrückung des Reasonings wurde korrekt gesetzt und im Server-Log verifiziert, konnte aber nicht greifen, weil das Modell keinen strukturierten <think>-Block erzeugte. Das war ein separates Ausgabeproblem und erklärte nicht die hohe Grundlast vor der Antwort.
Als nächster Kandidat bot sich die Websuche an. Suchresultate können schnell mehrere Tausend Zeichen in einen Chat einbringen. Auch hier zeigte die spätere Messung jedoch: Die Websuche verursacht messbaren Zusatzaufwand, ist aber nicht der Hauptverursacher.
49.152 Tokens bedeuten nicht automatisch 49.152 Tokens pro Chat
Parallel zur Analyse des MCP-Overheads fiel im ursprünglichen Testaufbau ein zweiter, davon unabhängiger Effekt auf.
Das Modell war in Jans integrierter llama.cpp-Runtime mit einem Gesamtkontext von:
49.152 Tokenskonfiguriert.
Die Runtime arbeitete jedoch mit zwei effektiven Slots. Neben dem eigentlichen Benutzer-Slot reservierte Jan einen weiteren internen Slot für Hintergrundanforderungen.
Damit ergab sich im damaligen Jan-llama.cpp-Setup:
Gesamtkontext:          49.152
effektive Slots:             2
──────────────────────────────
Kontext pro Slot:        24.576
Für einen einzelnen Chat standen damit effektiv nur rund 24.576 Tokens zur Verfügung.
Wichtig: Dieses Verhalten ist kein Ollama-Verhalten. Es betrifft die integrierte llama.cpp-Runtime von Jan.
Im vorgesehenen produktiven Aufbau wird die Inferenz deshalb nicht mehr von Jans internem llama-server übernommen. Stattdessen arbeitet Jan gegen eine eigene lokale Ollama-Serverinstanz:
Jan
 │
 ├── Projects
 ├── Web Search
 ├── MCP / Memory Wrapper
 │
 └── OpenAI-kompatible API
          │
          ▼
     eigener Ollama Server
          │
          ▼
       lokales LLM
Damit bestimmt die Konfiguration des Ollama-Servers den verfügbaren Modellkontext. Jans interner zweiter llama.cpp-Slot spielt für diese Modelle keine Rolle mehr.
Der Slot-Effekt war daher zwar für die ursprüngliche Messumgebung relevant, ist aber nicht die Ursache der 6.300 Tokens Grundlast und auch kein Bestandteil der späteren Ollama-Architektur.
Der A/B/C/D-Test
Statt weiter zu spekulieren, wurde für jede Variante ein neuer Chat geöffnet und immer dieselbe minimale Anfrage gestellt:
Antworte ausschließlich mit OK.
Es fand kein bewusster Werkzeugaufruf statt. Gemessen wurde lediglich der Input-Kontext, den Jan dem Modell für diesen simplen Turn mitgab. Die folgenden Werte wurden im ursprünglichen Jan-Testaufbau mit der integrierten llama.cpp-Runtime erhoben. Entscheidend ist jedoch die Differenz zwischen den Konfigurationen: Der nachgewiesene Tool-Schema-Overhead entsteht auf der LLM-/Tool-Schnittstelle und ist nicht auf llama.cpp beschränkt. Das Optimierungsprinzip ist deshalb ebenso auf einen externen Ollama-Server und andere MCP-fähige Model-Backends übertragbar.
| Test | Konfiguration | Input-Tokens |
|---|---|---|
| A | ohne Basic Memory, ohne Websuche | 591 |
| B | Basic Memory mit 8 Tools, ohne Websuche | 5.800 |
| C | ohne Basic Memory, mit Websuche | 1.200 |
| D | Basic Memory mit 8 Tools und Websuche | 6.300 |
Damit war die Ursache praktisch isoliert.
Der Sprung von Test A zu Test B beträgt:
5.800 - 591 = 5.209 TokensAllein die Verfügbarkeit der acht Basic-Memory-Werkzeuge kostete also rund 5.200 Tokens.
Keines dieser Werkzeuge war dabei aufgerufen worden.
Der eigentliche Kontextfresser: Tool-Schemas
Ein LLM kann ein Werkzeug nur sinnvoll verwenden, wenn es weiß, wie dieses Werkzeug aussieht. Deshalb erhält es für verfügbare Tools Beschreibungen wie Werkzeugname, Zweck, Parameter, Datentypen, Pflichtfelder, mögliche Optionen und weitere Schema-Informationen.
Dieser Kontext wird benötigt, bevor überhaupt feststeht, ob das Tool anschließend benutzt wird.
Bei Basic Memory verursachten die acht verbliebenen Werkzeuge zusammen rund 5.209 Tokens Tool-Overhead. Rein rechnerisch entspricht das ungefähr 650 Tokens pro Tool, wobei dieser Wert nur eine Größenordnung darstellt: Manche Schemas sind erheblich umfangreicher als andere.
Der Vergleich mit der Websuche machte die Dimension deutlich:
Websuche:       ca. +609 Tokens
Basic Memory:   ca. +5.209 Tokens
Damit war die ursprüngliche Diagnose auf den Kopf gestellt. Nicht das Reasoning, nicht die Websuche und auch nicht der eigentliche gespeicherte Inhalt waren das Hauptproblem.
Das Problem war die Größe der Schnittstelle zwischen LLM und Werkzeugen.
Die Lösung: Basic Memory behalten, aber dem Modell weniger davon zeigen
Basic Memory selbst sollte ausdrücklich nicht ersetzt werden. Persistente Notizen, semantische Suche, Volltextsuche, Embeddings, Markdown-Speicherung und die vorhandenen Projektinhalte funktionierten bereits gut.
Zu groß war lediglich die Oberfläche, die dem Sprachmodell präsentiert wurde.
Die Lösung war deshalb ein eigener, kleiner MCP-Server vor Basic Memory. Der memory-wrapper bietet dem Modell nur vier Funktionen an:
memory_search(query, limit)
memory_read(identifier)
memory_write(title, content)
memory_update(identifier, content)
Aus Sicht des LLMs besteht Memory damit nur noch aus vier klar verständlichen Aktionen:
suchen, lesen, schreiben und ändern.
Die komplexere Funktionalität von Basic Memory bleibt vollständig dahinter verborgen.
Die resultierende Architektur
Der Aufbau sieht damit so aus:
Jan
│
├── Projects / Assistants
├── Web Search
│
├── Compact Memory MCP
│ │
│ ├── memory_search
│ ├── memory_read
│ ├── memory_write
│ └── memory_update
│ │
│ ▼
│ Basic Memory FastAPI v2
│ │
│ In-Process via ASGI
│ │
│ Vault + Embeddings
│
└── OpenAI-kompatibler Model Provider
│
▼
eigener Ollama Server
│
▼
lokales LLM
Damit sind die Zuständigkeiten sauber getrennt:
Jan übernimmt Oberfläche, Projekte, Websuche und Tool-Orchestrierung.
Der Memory-Wrapper reduziert den MCP-Schema-Overhead.
Basic Memory übernimmt persistentes Wissen und Retrieval.
Der eigene Ollama-Server übernimmt ausschließlich die Modellinferenz.
Der Vorteil dieser Trennung besteht darin, dass die Optimierung der MCP-Werkzeuge unabhängig von der verwendeten Inferenz-Runtime bleibt. Das Modell kann später über Ollama, llama.cpp oder einen anderen OpenAI-kompatiblen Server bereitgestellt werden, ohne dass der Memory-Wrapper dafür geändert werden muss.
Projektwissen bleibt serverseitig
Ein weiterer wichtiger Schritt war die Entfernung der Projektinformation aus dem Tool-Schema.
Eine generische Schnittstelle könnte beispielsweise so aussehen:
memory_search(
    query,
    project,
    mode,
    filters,
    ...
)
Für das Sprachmodell bedeutet jeder zusätzliche Parameter wiederum mehr Schema und mehr Entscheidungen.
Der Wrapper erhält das Zielprojekt deshalb beim Start über eine Umgebungsvariable:
BM_PROJECT=it-technikoder beispielsweise:
BM_PROJECT=18bravoDas LLM sieht nur:
memory_search(query, limit)Die Projektzuordnung ist damit ein Infrastrukturdetail und kein Problem des Modells.
Ein einziges Wrapper-Skript kann so für beliebig viele Basic-Memory-Projekte verwendet werden.
Der Wrapper
Der vollständige Server bleibt mit gut 130 Zeilen Python überschaubar:
"""Schlanker MCP-Server vor Basic Memory: 4 einfache Werkzeuge statt 8 umfangreicher.

Nutzt Basic Memorys eigene oeffentliche Grenze -- die FastAPI-v2-Router -- ueber den
dokumentierten In-Process-ASGI-Weg (basic_memory.mcp.async_client.get_client), genau das
Muster, das Basic Memorys eigener MCP-Server fuer lokale Aufrufe selbst verwendet. Kein
zweiter Prozess, kein zweiter Port, keine zweite DB-Verbindungsschicht.

Projekt ist fest pro Serverinstanz (Umgebungsvariable BM_PROJECT), taucht NICHT in den
Werkzeug-Schemas auf -- das Modell sieht nur: suchen, lesen, schreiben, aendern.

Konfiguration ueber Umgebungsvariablen:
  BM_PROJECT   Name des Basic-Memory-Projekts (Pflicht), z. B. "it-technik"

Transport: stdio.
"""
from __future__ import annotations

import os
import sys

from mcp.server.mcpserver import MCPServer


def _log(msg: str) -> None:
    print(msg, file=sys.stderr, flush=True)


PROJECT_NAME = os.environ.get("BM_PROJECT")
if not PROJECT_NAME:
    raise SystemExit("BM_PROJECT ist nicht gesetzt")

server = MCPServer("memory")

# Project-ID wird beim ersten Aufruf aufgeloest und fuer die Laufzeit des Prozesses zwischengespeichert.
_project_id: str | None = None


async def _resolve_project_id(project_client) -> str:
    global _project_id
    if _project_id is None:
        resolved = await project_client.resolve_project(PROJECT_NAME)
        _project_id = resolved.external_id
        _log(f"memory-wrapper: Projekt '{PROJECT_NAME}' -> {_project_id}")
    return _project_id


@server.tool(name="memory_search", description="Durchsucht das Gedaechtnis nach einem Stichwort/Satz und liefert die besten Treffer mit kurzem Auszug.")
async def memory_search(query: str, limit: int = 5) -> str:
    from basic_memory.mcp.async_client import get_client
    from basic_memory.mcp.clients.project import ProjectClient
    from basic_memory.mcp.clients.search import SearchClient

    try:
        async with get_client(project_name=PROJECT_NAME) as http_client:
            project_id = await _resolve_project_id(ProjectClient(http_client))
            # hybrid: kombiniert Stichwortsuche (FTS) mit der gestern eingerichteten
            # semantischen Suche (deutsches Embedding-Modell) -- nicht nur FTS.
            resp = await SearchClient(http_client, project_id).search(
                {"text": query, "retrieval_mode": "hybrid"}, page_size=limit
            )
        if not resp.results:
            return "Keine Treffer."
        lines = []
        for r in resp.results[:limit]:
            snippet = (r.matched_chunk or r.content or "").strip().replace("\n", " ")[:160]
            lines.append(f"- {r.title} ({r.permalink}) score={r.score:.2f}\n  {snippet}")
        return "\n".join(lines)
    except Exception as exc:
        return f"Fehler bei der Suche: {exc}"


@server.tool(name="memory_read", description="Liest eine Notiz vollstaendig anhand von Titel oder Permalink.")
async def memory_read(identifier: str) -> str:
    from basic_memory.mcp.async_client import get_client
    from basic_memory.mcp.clients.project import ProjectClient
    from basic_memory.mcp.clients.knowledge import KnowledgeClient

    try:
        async with get_client(project_name=PROJECT_NAME) as http_client:
            project_id = await _resolve_project_id(ProjectClient(http_client))
            kc = KnowledgeClient(http_client, project_id)
            entity_id = await kc.resolve_entity(identifier)
            entity = await kc.get_entity(entity_id)
        return f"# {entity.title} ({entity.permalink})\n\n{entity.content or ''}"
    except Exception as exc:
        return f"Nicht gefunden oder Fehler: {exc}"


@server.tool(name="memory_write", description="Legt eine neue Notiz mit Titel und Inhalt an.")
async def memory_write(title: str, content: str) -> str:
    from basic_memory.mcp.async_client import get_client
    from basic_memory.mcp.clients.project import ProjectClient
    from basic_memory.mcp.clients.knowledge import KnowledgeClient

    try:
        async with get_client(project_name=PROJECT_NAME) as http_client:
            project_id = await _resolve_project_id(ProjectClient(http_client))
            kc = KnowledgeClient(http_client, project_id)
            entity = await kc.create_entity({"title": title, "content": content, "directory": ""})
        return f"Gespeichert: {entity.permalink}"
    except Exception as exc:
        return f"Fehler beim Speichern: {exc}"


@server.tool(name="memory_update", description="Ersetzt den Inhalt einer vorhandenen Notiz (Titel oder Permalink angeben).")
async def memory_update(identifier: str, content: str) -> str:
    from basic_memory.mcp.async_client import get_client
    from basic_memory.mcp.clients.project import ProjectClient
    from basic_memory.mcp.clients.knowledge import KnowledgeClient

    try:
        async with get_client(project_name=PROJECT_NAME) as http_client:
            project_id = await _resolve_project_id(ProjectClient(http_client))
            kc = KnowledgeClient(http_client, project_id)
            entity_id = await kc.resolve_entity(identifier)
            # update_entity ist ein vollstaendiger Ersatz (PUT) -- Titel/Ordner der
            # bestehenden Notiz zuerst lesen und unveraendert mitschicken, nur der
            # Inhalt wird ersetzt. (patch_entity waere fuer append/prepend-Operationen,
            # nicht fuer einfaches Ersetzen.)
            current = await kc.get_entity(entity_id)
            directory = current.file_path.rsplit("/", 1)[0] if "/" in current.file_path else ""
            entity = await kc.update_entity(entity_id, {
                "title": current.title,
                "content": content,
                "directory": directory,
                "note_type": current.note_type,
            })
        return f"Aktualisiert: {entity.permalink}"
    except Exception as exc:
        return f"Fehler beim Aktualisieren: {exc}"


if __name__ == "__main__":
    _log(f"memory-wrapper: 4 Werkzeuge registriert, Projekt='{PROJECT_NAME}'")
    server.run("stdio")
Einbindung in Jan
Der Wrapper wird als normaler STDIO-MCP-Server in Jans MCP-Konfiguration hinterlegt. Für jedes Memory-Projekt kann dieselbe Python-Datei verwendet werden; lediglich BM_PROJECT ändert sich.
Beispielsweise:
{
  "memory-it-technik": {
    "command": "C:\\tools\\memory-wrapper\\.venv\\Scripts\\python.exe",
    "args": [
      "C:\\tools\\memory-wrapper\\server.py"
    ],
    "env": {
      "BM_PROJECT": "it-technik"
    },
    "active": true
  },
  "memory-18bravo": {
    "command": "C:\\tools\\memory-wrapper\\.venv\\Scripts\\python.exe",
    "args": [
      "C:\\tools\\memory-wrapper\\server.py"
    ],
    "env": {
      "BM_PROJECT": "18bravo"
    },
    "active": true
  }
}
Die MCP-Konfiguration selbst ist dabei global in Jan. Welche projektbezogene Memory-Instanz aktiv sein soll, muss entsprechend zur jeweiligen Arbeitsumgebung passen.
Zwei Details, die beim Bau wichtig wurden
Hybride Suche muss explizit erhalten bleiben
Basic Memory unterstützt unterschiedliche Retrieval-Verfahren. Ohne explizite Angabe wäre der Wrapper zunächst auf die textbasierte Suche zurückgefallen.
Deshalb wird bewusst:
retrieval_mode = hybridgesetzt.
Damit kombiniert die Suche Volltext- und Vektorretrieval.
Das wurde anschließend nicht nur technisch geprüft, sondern auch inhaltlich getestet: Eine Anfrage wurde bewusst so umformuliert, dass die entscheidenden Begriffe aus der gespeicherten Notiz nicht wörtlich vorkamen. Trotzdem wurde die korrekte Notiz gefunden.
Damit war bestätigt, dass die zuvor konfigurierte semantische Suche weiterhin genutzt wurde.
Für vollständige Änderungen PUT statt PATCH
Beim ersten Versuch wurde für Änderungen an bestehenden Notizen die PATCH-Schnittstelle verwendet.
Das war für diesen Anwendungsfall nicht passend. PATCH ist für strukturierte Teiloperationen wie Anhängen oder Voranstellen gedacht.
Soll der Inhalt einer Notiz vollständig ersetzt werden, ist update_entity über PUT der richtige Weg.
Danach funktionierte der komplette Ablauf fehlerfrei:
Schreiben
→ Lesen
→ Ändern
→ erneut Lesen
→ Aufräumen
Das Ergebnis
Die gemessene Reduktion fiel größer aus als zunächst erwartet:
| Messgröße | Vorher | Nachher | Reduktion |
|---|---|---|---|
| Tool-Schema-Kosten der Memory-Anbindung | 5.209 Tokens | 754 Tokens | −85 % |
| kompletter Jan-Sockel mit Memory + Websuche | 6.300 Tokens | ca. 1.500 Tokens | −76 % |
Die Werte von etwa 6.300 beziehungsweise 1.500 Tokens stammen aus der ursprünglichen Jan-Testumgebung und zeigen den Effekt der MCP-Optimierung.
Für die damalige integrierte llama.cpp-Runtime bedeutete das:
Vorher:
6.300 / 24.576 = 25,6 %

Nachher:
1.500 / 24.576 = 6,1 %
Die Bezugsgröße von 24.576 Tokens resultierte ausschließlich aus Jans damaliger Zwei-Slot-Konfiguration.
Beim Betrieb über die eigene Ollama-Serverinstanz gilt diese Halbierung nicht automatisch. Dort richtet sich der nutzbare Kontext nach der für das Ollama-Modell konfigurierten Context Length und der Parallelitätskonfiguration des Servers.
Die eigentliche Aussage der Messung bleibt davon unberührt: Der statische MCP-Sockel konnte im Test von rund 6.300 auf etwa 1.500 Tokens reduziert werden.
Was erhalten blieb
Der Wrapper reduziert nur die Schnittstelle zum Sprachmodell. Das Backend kann weiterhin persistente projektbezogene Notizen speichern, semantisch und per Volltext suchen, bestehende Inhalte verwenden sowie Informationen lesen, schreiben und aktualisieren.
Der entscheidende Unterschied lautet:
Das LLM muss nicht mehr verstehen, wie komplex Basic Memory intern funktioniert.
Es muss lediglich wissen, dass es Informationen suchen, lesen, schreiben und ändern kann.
Die eigentliche Erkenntnis
Bei der Optimierung lokaler LLM-Setups wird häufig zuerst auf Modellgröße, Quantisierung, Context Size, VRAM oder Sampling geschaut.
Das sind wichtige Stellschrauben.
In diesem Fall lag der größte Hebel jedoch an einer ganz anderen Stelle: an der Größe der Tool-Schnittstelle.
Ein Backend darf intern komplex sein. Für das Sprachmodell sollte die Oberfläche dagegen möglichst klein, eindeutig und auf den konkreten Anwendungsfall zugeschnitten sein.
Acht generische Memory-Werkzeuge wurden deshalb nicht durch weniger Funktionalität ersetzt, sondern durch vier fachlich klarere Operationen:
suchen, lesen, schreiben, ändern.
Das ist ein wesentlicher Unterschied.
Fazit
Wer lokale LLMs mit MCP, RAG, Memory und weiteren Werkzeugen betreibt, sollte den statischen Kontext-Overhead seiner Tools ausdrücklich messen.
Der konkrete Versuch wurde zwar mit Basic Memory und zunächst mit Jans integrierter llama.cpp-Runtime durchgeführt. Die Erkenntnis ist jedoch weder auf Basic Memory noch auf llama.cpp beschränkt.
Jedes MCP-Tool, dessen Schema dem Modell zur Verfügung gestellt wird, benötigt Kontext – unabhängig davon, ob dahinter Ollama, llama.cpp oder ein anderer Model-Server arbeitet.
Die spätere Architektur trennt diese beiden Themen deshalb bewusst:
MCP-Overhead
→ durch schlanke Tool-Schemas reduzieren

Modell-Runtime
→ über eigenen Ollama-Server bereitstellen
Damit wird Jans Zwei-Slot-Verhalten der integrierten llama.cpp-Runtime nicht durch Tricks kompensiert, sondern vollständig aus dem Modellpfad herausgenommen.
Die eigentliche Lehre bleibt:
Nicht weniger Backend-Funktionalität, sondern weniger unnötige Schnittstellenkomplexität für das Modell.
Das Ergebnis im Test: rund 76 Prozent weniger Grundlast im realen Chat bei weiterhin vollständigem persistentem Memory.
Und das Optimierungsmuster ist auf praktisch jedes MCP-basierte Tooling übertragbar – unabhängig davon, ob die eigentliche Inferenz auf einem eigenen Ollama-Server, über llama.cpp oder einem anderen lokalen beziehungsweise entfernten Model-Backend erfolgt.