Mit meinem lokalen KI-Stack wollte ich irgendwann nicht mehr nur einzelne Aktien analysieren oder allgemeine Fragen zum Markt stellen. Interessanter wurde die Frage, ob daraus ein eigener Trading-Agent werden kann: ein System, das mein tatsächliches Depot kennt, Transaktionen nachvollziehen kann, Watchlist-Kandidaten verwaltet und Entscheidungen nicht aus einem isolierten Chat heraus trifft.
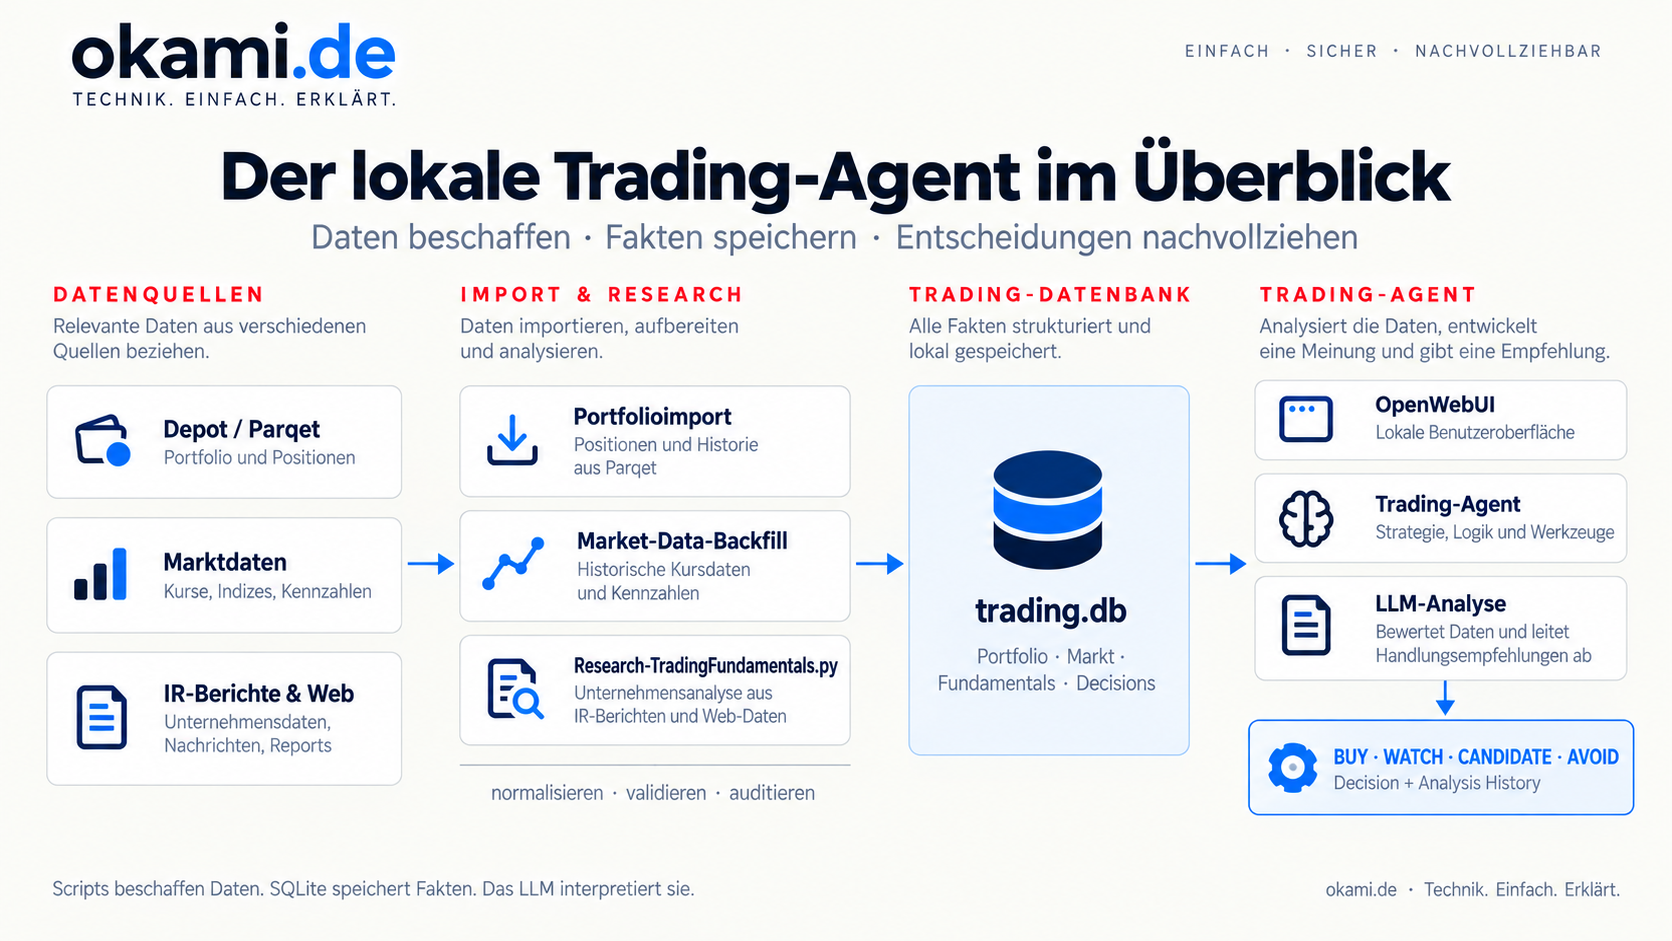
Kurz gesagt: Der Agent bündelt Informationen zu Depot, Markt und Unternehmen, damit eine Investmententscheidung auf nachvollziehbaren Fakten basiert. Für einen Swing-Horizont von drei bis sechs Monaten reicht es nicht, ein Unternehmen pauschal als gut oder schlecht einzuordnen. Einstieg, Bewertung, Momentum, Analystenrevisionen, bevorstehende Ereignisse, bestehende Positionen und die Frage, wie gut ein weiterer Trade in das Portfolio passt, gehören zusammen. Der Agent ist dabei kein automatisches Handelssystem: Er bereitet Entscheidungen vor; Käufe und Verkäufe bleiben beim Menschen.
Architektur und Betriebsablauf des Trading-Agenten
Der Trading-Agent ist keine eigenständige Anwendung neben dem KI-Stack, sondern eine spezialisierte Konfiguration innerhalb davon. Scripts sammeln und normalisieren Daten, SQLite speichert den dauerhaften Zustand, Tools stellen die passenden Ausschnitte bereit und das Sprachmodell bewertet die Informationen. Das Modell selbst ist ausdrücklich nicht die Datenhaltung.
LM Studio stellt das lokale Modell über den Service auf Port 1234 bereit. OpenWebUI ist Benutzeroberfläche und Agentenplattform; dort liegen Systemprompt, Modellwahl und die gezielt freigegebenen Tools. Die bestehende MCP-Runtime auf Port 8021 bleibt Teil des KI-Stacks, liegt für den lokalen Zugriff auf die Trading-Datenbank jedoch bewusst nicht im Datenpfad. Ein zusätzlicher HTTP- oder MCP-Hop vor SQLite würde hier nur Abhängigkeiten und Fehlerquellen schaffen.
Die Architektur bleibt absichtlich pragmatisch. Das Ziel ist kein System für hundert Nutzer und Millionen Wertpapiere, sondern ein lokaler, nachvollziehbarer Agent für ein eigenes Portfolio: SQLite statt zusätzlichem Datenbankserver, direkter Python-Zugriff statt eigener REST-Schicht, kleine Scripts statt Framework und ein gemeinsamer Datenbestand statt verteilter Zustände.
Was dauerhaft läuft – und was nur bei Bedarf startet
LM Studio und OpenWebUI gehören zum normalen Betrieb. Wird der Trading-Agent in OpenWebUI ausgewählt, werden zunächst nur Modell, Systemprompt und freigegebene Tools geladen. Es startet nicht bei jeder Unterhaltung automatisch ein vollständiger Depotimport oder eine erneute Zweijahreshistorie aller Kurse. Welche Daten abgefragt werden, hängt von der konkreten Frage ab.
Noch nicht jeder dieser Prozesse ist ein fertiger automatischer Scheduler. Der entscheidende Grundsatz steht aber bereits fest: Der Agent soll Daten verwenden und bewerten, nicht selbst zur Datenversorgung werden.
SQLite als gemeinsamer und reproduzierbarer Zustand
Die zentrale Trading-Datenbank läuft mit WAL und bildet Schema-Version 2.0 ab. Sie ist die verlässliche Datenquelle: Wenn ein Modell in einer Unterhaltung einen Bestand behauptet, die Datenbank aber null Stück ausweist, gewinnt die Datenbank. Weder Stückzahlen noch Einstandskurse oder Transaktionen werden aus alten Chats rekonstruiert.
ChromaDB bleibt davon getrennt. Der Vektorstore gehört zum allgemeinen RAG des KI-Stacks und ist für unstrukturierte Dokumente sinnvoll. Depot- und Marktdaten gehören bewusst in eine relationale Datenbank.
Der Schema-Stand umfasst unter anderem:
PORTFOLIO
security · transactions · positions · watchlist

MARKTDATEN
market_data · market_snapshot · fundamentals · estimates
ratings · events · news · source_symbols · data_sources

AGENT / AUDIT
decisions · analysis_history · imports · metadata
Diese Trennung schützt Verantwortlichkeiten. Ein Depotimport darf Positionen ändern, aber keine Analystenschätzung überschreiben. Ein Market-Data-Backfill darf Kurshistorien aktualisieren, aber keine Transaktionen verändern. Der Agent speichert Analyse und Entscheidung, entfernt aber niemals eigenständig Aktien aus dem realen Depot.
security als verbindende Ebene
Der zentrale Schlüssel ist die security_id, nicht der Unternehmensname. Internationale Aktien können bei verschiedenen Quellen unterschiedliche Symbole haben. Eine Security referenziert daher Stammdaten wie Symbol, ISIN, Börse, Währung und Land; providerabhängige Kennungen liegen zusätzlich in source_symbols.
SK hynix zeigt, warum das nötig ist: Der Wert wird für den Provider korrekt über 000660.KS in KRW aufgelöst. Der Agent selbst muss dieses Detail nicht kennen. Er fragt nach SK hynix, während der Datenlayer das passende Provider-Symbol liefert.
Portfolioimport und Watchlist
Ausgangspunkt der Datenbank war ein Parqet-Export mit 432 Transaktionen und 46 Wertpapieren. Transaktionen sind die historische Wahrheit des Depots. Ein Kauf oder Teilverkauf wird nicht als überschriebenes Stückzahlfeld behandelt: Die ursprüngliche Bewegung bleibt erhalten, eine neue Transaktion wird ergänzt und daraus wird der aktuelle Positionsbestand berechnet.
Parqet / Depotdaten
   │
   ▼
Import und Normalisierung
   ├── Security identifizieren
   ├── Transaktion normalisieren
   ├── Duplikate vermeiden
   └── Import protokollieren
   ▼
transactions
   ▼
Positionsberechnung
   ▼
positions
Die Watchlist bleibt davon getrennt. Ein Wertpapier kann beobachtet werden, ohne dass bereits eine Position besteht; ein vollständig verkaufter Wert kann für einen Wiedereinstieg auf der Watchlist bleiben. Ein neuer Kandidat wird zuerst als Security registriert und zur Watchlist hinzugefügt. Provider-Symbole, Kurshistorie und Fundamentaldaten werden anschließend ergänzt. Die Watchlist ist ein Arbeitsinstrument, keine Datenqualitätsprüfung.
Market Data: Historie, Snapshot und inkrementelle Updates
Für historische Marktdaten sorgt ein eigenes Skript: Es ermittelt die relevanten Wertpapiere aus aktuellen Positionen und Watchlist, prüft Zuordnungen zu Datenquellen, lädt Kurse, normalisiert sie, schreibt sie in die Datenbank und erzeugt einen kompakten aktuellen Snapshot.
Im initialen Ausbau werden zwei Jahre Tageshistorie geladen. Der vollständige Backfill wurde erfolgreich abgeschlossen: 33 relevante Securities wurden aufgelöst, 16.501 historische Kurszeilen geschrieben sowie 33 Market Snapshots und 33 Provider-Mappings erzeugt. Danach wird nicht mehr jedes Mal der gesamte Zeitraum geladen. Über MAX(trading_date) bestimmt der Updater den letzten vorhandenen Handelstag und ergänzt nur neuere Kurse per UPSERT.
Die vollständige Historie bleibt für Trend- und Momentumbetrachtungen wichtig. market_snapshot hält zusätzlich häufig benötigte aktuelle Kennzahlen kompakt bereit, damit eine einfache Depotübersicht nicht immer die gesamte Tageshistorie auswerten muss.
Fehler, die den Datenlayer verbessert haben
Der Aufbau hat gezeigt, wie wichtig saubere Datenflüsse sind. Gerade beim Import, bei der Zuordnung von Wertpapieren und beim Aktualisieren von Kursen müssen alle Schritte klar voneinander getrennt sein.
Ein wichtiges Lernfeld war die fachliche Prüfung: Ein technisch erfolgreicher Import ist noch keine Garantie für korrekte Daten. Deshalb werden Kurs- und Kennzahlendaten zusätzlich auf Plausibilität geprüft.
Auch Wertpapierkennungen und Handelsplätze können sich ändern. Die Datenbasis bleibt deshalb überprüfbar und korrigierbar, statt einmal gefundene Zuordnungen ungeprüft fortzuschreiben.
Fundamentals: LLM für Interpretation, Python für Hardchecks
Kurse allein reichen für eine fundierte Entscheidung nicht. Der Agent benötigt Umsatz, Ergebnis, EPS, Free Cashflow, Cash, Verschuldung und vor allem die Entwicklung dieser Kennzahlen über mehrere Berichtsperioden. Genau hier unterscheiden sich Fundamentals von Kursdaten: Sie beziehen sich auf Quartale, Halbjahre oder Geschäftsjahre und müssen semantisch richtig gelesen werden.
US-Unternehmen lassen sich oft über SEC-Daten strukturiert verarbeiten, Investor-Relations-Berichte europäischer und asiatischer Unternehmen sind jedoch sehr unterschiedlich aufgebaut. Ein universeller Parser würde schnell selbst zum Großprojekt. Die Architektur trennt deshalb bewusst Aufgaben:
LLM
Web-Recherche · Reports verstehen · Kennzahlen interpretieren · Mapping

Python
Security lesen · Prompt erzeugen · JSON prüfen · Hardchecks · Audit · DB-I/O
Das kanonische Tool heißt Research-TradingFundamentals.py. Es ersetzt keinen der bestehenden produktiven Importer und baut keine zweite Tool-Linie auf. Die vorhandenen SEC-, IR- und Market-Data-Scripts bleiben als Referenz, Fallback und Regressionstest erhalten, werden aber nicht zu einem wachsenden Netz firmenbezogener Parser ausgebaut.
Security aus der DB
   ▼
Research-Prompt
   ▼
LLM recherchiert offizielle IR-Quellen und Berichte
   ▼
strukturiertes JSON
   ▼
Python-Hardchecks
   ├── Datentypen und Pflichtfelder
   ├── Perioden- und Security-Zuordnung
   ├── Plausibilität und Verification Status
   ├── Konflikte mit vorhandenen Werten
   └── Audit-JSON
   ▼
idempotenter DB-Write
   ▼
fundamentals
Das LLM übernimmt damit Recherche, Interpretation und Mapping – genau dort, wo unterschiedlich aufgebaute Finanzberichte klassische Parser kompliziert machen. Python bleibt klein und deterministisch: Es validiert, protokolliert und schreibt nur akzeptierte Kandidaten.
Verifikation vor dem Datenbank-Write
Jede Berichtsperiode wird zunächst als Candidate mit Quelle, Dokument, Datum, Kennzahl, Originalbezeichnung und Verification Status abgelegt. Der Validator prüft Periodenlogik, Währung und Einheiten, Plausibilität von Umsatz und Bruttogewinn, Bilanzgleichung, Free-Cashflow-Rechnung sowie die semantische Zuordnung. Nicht verifizierte Werte bleiben NULL; eine fehlende Zahl ist besser als eine erfundene.
Einige Regeln sind besonders wichtig: Kumulierte Halbjahres- oder Neunmonatswerte werden nicht als eigenständige Quartale gespeichert. Capex wird als positiver Outflow behandelt, sodass free_cash_flow = operating_cash_flow - capex gilt. total_debt wird nur gesetzt, wenn sich die vollständige Bruttoverschuldung belastbar ableiten lässt. Adjusted- und Underlying-Kennzahlen ersetzen keine verfügbaren IFRS-/GAAP-/statutory Werte.
Die Quelle bleibt Company IR. Weil handvalidierte Importer und LLM-Research damit denselben Source-Kontext nutzen können, ist ein Konfliktschutz unverzichtbar: Existiert für security_id + period_end + period_type + source_id bereits ein abweichender Wert, wird ohne --force übersprungen. Identische Werte dürfen als Refresh durchlaufen. Nur --force erlaubt bewusstes Überschreiben. --validate-only schreibt niemals, --write schreibt nur valide Werte. Ein Massenschalter --all wird vorerst nicht gebaut.
Jeder Lauf erzeugt eine nachvollziehbare Audit-Datei mit Wertpapier, verwendeten Quellen, Prüfergebnissen, Konflikten sowie den final übernommenen Werten.
Reale Fundamentals-Fälle und ihre Grenzen
Der Ansatz wurde mit unterschiedlichen Unternehmen, Ländern und Berichtsformaten erprobt. Dabei zeigte sich: Ein einheitlicher Ablauf kann funktionieren, solange die Daten geprüft und bei Unsicherheit nicht automatisch übernommen werden.
Die Tests machen zugleich die Grenzen deutlich: Kennzahlen können in Berichten unterschiedlich bezeichnet oder dargestellt sein. Deshalb bleiben Quellen, Prüfungen und manuelle Kontrolle Teil des Prozesses.
Neben den Finanzdaten müssen auch Stammdaten wie Währung, Land oder Wertpapierkennung vollständig und plausibel bleiben.
Weitere Unternehmen werden schrittweise ergänzt, bevor die Abläufe weiter automatisiert werden.
Analystenschätzungen, Ratings, Events und News
Für einen Swing-Horizont zählt nicht nur der absolute Wert einer Schätzung, sondern die Richtung. Ein EPS-Estimate von 2,10 über 2,25 auf 2,40 ist eine andere Lage als 2,70 über 2,50 auf 2,30 – selbst wenn beide Unternehmen profitabel bleiben. Deshalb werden Estimates, Ratings, Kursziele und Events historisiert beziehungsweise gezielt ergänzt.
Historische Daten wie Transaktionen, Quartalszahlen, Kursverläufe, alte Analystenrevisionen und Entscheidungen eignen sich für lokale Speicherung. Breaking News, frische Quartalsberichte, neue Analystenänderungen und besondere Unternehmensereignisse können bei Bedarf live recherchiert werden. So entsteht ein Hybridmodell: Die Datenbank liefert den reproduzierbaren Grundbestand, Recherche ergänzt nur, was sich seit dem letzten Update geändert haben könnte.
Der Agent nutzt nicht immer alle Daten
Nicht jede Anfrage braucht jede Tabelle oder jede externe Quelle. Bei „Wie sieht mein Depot aus?“ reichen im Wesentlichen positions, market_snapshot und bei Bedarf die zugehörigen Transaktionen. Bei „Soll ich RENK nachkaufen?“ benötigt der Agent deutlich mehr Kontext:
Security und Provider-Mappings
   ▼
aktuelle Position und Transaktionen
   ▼
Market Snapshot und Kursverlauf
   ▼
Fundamentals
   ▼
Estimates / Ratings / Events / News
   ▼
bestehende Decisions
   ▼
Portfolio-Fit
   ▼
LLM-Analyse
   ▼
BUY / CANDIDATE / WATCH / DEFERRED / AVOID / INSUFFICIENT_DATA
   ▼
decisions und analysis_history
Der Agent beurteilt damit nicht nur ein Unternehmen, sondern dieses Unternehmen im eigenen Depot und zum eigenen Einstiegszeitpunkt. Ein guter Halbleiterwert ist nicht automatisch ein guter Kauf, wenn das Portfolio bereits stark in Halbleiter konzentriert ist. Unternehmensqualität, Bewertung, Momentum, fundamentale Entwicklung, Analystenrevisionen, Eventrisiken, Sektor, Positionsgröße, Korrelation und Chance-Risiko-Verhältnis werden deshalb gemeinsam betrachtet.
Das strategische Zielbild liegt ungefähr bei 60–70 % langfristigen ETFs und 30–40 % Swing- beziehungsweise Einzelaktien. Für Swing-Positionen bleibt ein Gewinnmitnahmemodell nur als Leitplanke bestehen: ungefähr bei +20 % kann ein Viertel der ursprünglichen Position verkauft werden, bei rund +25 % weitere 50 %. Das sind keine automatischen Handelsregeln, sondern ein Rahmen für die Bewertung.
Entscheidungshistorie statt Chat-Erinnerung
In decisions wird nicht nur ein Status, sondern auch die Investmentthese gespeichert. So kann sich eine Einschätzung nachvollziehbar entwickeln:
WATCH      Bewertung zu hoch
   ▼
CANDIDATE  Kurs gefallen, Estimates stabil
   ▼
BUY        Bewertung attraktiver, positive Revisionen, Momentum stabilisiert
analysis_history bildet daneben das technische Gedächtnis: Zeitpunkt, Security, Analyseart, Modell, Prompt-Version und Ergebnis. Damit lässt sich später unterscheiden, ob sich eine Einschätzung wegen neuer Marktdaten oder wegen eines Modell- beziehungsweise Promptwechsels verändert hat.
Was Prompt und Tools lernen mussten
Auch die Zusammenarbeit von Prompt, Datenbank und Tools musste schrittweise geschärft werden. Der Prompt setzt den strategischen Rahmen; die Tools liefern die Daten. So bleibt eine einfache Abfrage eine Abfrage und wird nicht unnötig zu einer Investmentthese aufgebläht.
Die Erfahrung zeigt: Ein Sprachmodell lässt sich erst sinnvoll bewerten, wenn die technische Grundlage zuverlässig arbeitet. Deshalb werden Datenquellen, Datenbankzugriff und Werkzeuge unabhängig vom Modell überprüft.
Welches Modell langfristig am besten passt, bleibt eine offene Frage. Entscheidend ist zunächst eine stabile und nachvollziehbare Umgebung.
Die Debugging-Kette
Ein großer Fortschritt liegt nicht darin, jeden Fehler vorherzusehen, sondern ihn klar einer Schicht zuordnen zu können:
Datenquelle
   ▼
Research / Import
   ▼
Normalisierung
   ▼
SQLite
   ▼
Tool
   ▼
Prompt
   ▼
LLM
   ▼
Decision
Ist previous_close falsch, muss nicht das Modell optimiert werden. Ist ein Provider-Symbol falsch, ist das kein Fundamental-Research-Problem. Erst wenn alle Eingangsdaten stimmen und trotzdem eine schlechte Entscheidung entsteht, richtet sich der Blick sinnvoll auf Prompt und Modell.
Aktueller Stand und Fazit
Stand 20. September 2026 ist die Trading-Datenbank in Schema 2.0 produktiv nutzbar. Portfolioimport, Symbolauflösung, Market-Data-Backfill, Snapshots und die zentralen Research-Workflows sind klar getrennt. Veraltete Marktdaten wurden bereinigt, SQLite-Transaktionshandling und previous_close korrigiert. Die Fundamentals-Architektur ist absichtlich schlank: ein kanonisches Research-Tool, LLM-Recherche und Interpretation, Python-Hardchecks und idempotente Writes, vorhandene Parser als Fallback und Regression.
Der interessanteste Teil dieses Projekts ist damit nicht das Schreiben eines Prompts für Aktienanalysen. Die eigentliche Arbeit steckt in der Datenbasis und der sauberen Trennung von Verantwortlichkeiten. Scripts beschaffen Daten. SQLite speichert Fakten. Tools stellen sie bereit. Das LLM interpretiert sie. Der Agent trifft und dokumentiert die Entscheidung. Genau in dieser Reihenfolge soll das System weiter wachsen.